184:与陈哲的具身季报 26Q3:Astra 冲击后,通用模型会吃掉 Robotics 吗?
本期具身季报围绕 GPT-6 Astra 进入机器人任务展开:通用模型开始承担空间推理、动作监督和仿真研究工作,但精细接触与实时控制仍是专用模型和端侧系统的重要位置。 陈哲与主持人还讨论了世界模型公司的收购路径、宇树上市后的估值与收入压力、视频示范式 ICL,以及 FCC 限制对机器人供应链的影响。
晚点 LatePost 出品的中文科技与商业访谈,关注一线从业者和产业变化
本期具身季报围绕 GPT-6 Astra 进入机器人任务展开:通用模型开始承担空间推理、动作监督和仿真研究工作,但精细接触与实时控制仍是专用模型和端侧系统的重要位置。 陈哲与主持人还讨论了世界模型公司的收购路径、宇树上市后的估值与收入压力、视频示范式 ICL,以及 FCC 限制对机器人供应链的影响。
Henry 延与主持人回顾 2026 年第三季度的 AI 产品、研究与商业化变化:个人助理开始接入云端执行和跨设备上下文,Astra 等通用模型也展示出进入机器人控制的潜力。节目同时讨论多智能体协作的安全边界、科学探索中的实验验证,以及 OpenAI 与 Anthropic 的收入数据应如何结合统计口径、客户结构和算力承诺来解读。 讨论保留了关键条件:产品能力受制于生态授权和隐私,机器人与生物结果尚未等同于现实部署或治疗,收入增速也不能脱离成本与未来投入单独判断。
梁琛奇回顾自己从抖音社交、实时社交到猫箱的产品经历,解释了为何他认为 AI 娱乐需要等到推理成本、模态和用户习惯同时变化后才有机会起步。创业后的动念引线先用松果时刻观察普通人的表达,再以快速试验、专用模型和内容关系网络寻找实时互动内容的产品形态。 他预计新体验的雏形可能在一到两年内出现,但也把它会否如期出现视为公司最大的风险。
宇树上市之后,中国具身智能创业热潮到了一个高峰。晚点记者子南与玉萌(报道 《具身智能的金钱游戏》的两位作者)和主播一起复盘这场由金钱主导的竞速:行业 表象是融资远超研发投入,根源是技术仍处早期、进展难以观测,估值容易在高估与 低估之间摇摆。他们拆解了收入"做大术"——地方数据采集中心、科研教育与制造业 场景三大收入来源,以及机器人公司与供应链企业互为供应商加客户的生态;也讨论 了港股 18C 门槛下的 IPO 竞速、一级市场攒局式的融资结构与二级市场开始追问的 可验证指标。节目最后指向未来最重要的验证:1000 万小时数据能否证明模型 scaling,以及宇树上市后的定价会落在哪里。
晚点编辑部内部对谈,解析大模型蒸馏这场无人公开谈论的技术竞赛。 从蒸馏的技术定义与历史、张一鸣反对字节蒸馏的三个理由,到 Anthropic 点名中国公司、 阿里禁用 Claude Code 的连锁反应,再到斩杀线之下智能供需失衡的新问题。
本期晚点聊对谈 Recursive Superintelligence 联合创始人田渊栋,深度拆解 RSI(递归自进化)为什么从去年的冷门概念变成今年硅谷的共识性话题:coding agent 变强、模型能充当研究员,让「AI 改进 AI」的闭环第一次有可能成立。田渊栋分享了他去年八月与 GPT-5 合写论文时看到信号、决定创业的契机,分析 Anthropic 与 OpenAI 的公开时间表,并指出「率先实现 RSI 就会强者愈强」这个假设的漏洞——他推演进步是 S 型曲线加平台期,scaling law 不是全部。节目还详细解读了该公司 First Steps 三个 benchmark 的 SOTA 成果,以及他作为可解释性少数派的信念:AI 终将变成科学。
晚点聊第 177 期,赵成阳与曾致远分别从 infra 与算法两条线拆解 Kimi K3 的 47 页技术报告:为什么说它是一艘"忒修斯之船",混合注意力、Attention Residues 与删掉位置编码各自解决了什么问题,以及 K3 如何点燃美国的开源大辩论、冲击闭源模型的估值叙事。节目还深入讨论了两个 KDA(Kimi Delta Attention 与 Kernel Development Agents)、MOPD 后训练配方,以及"环境是更重要的护城河"的开源边界。
晚点主笔高洪浩与主持人曼琪复盘他 7 月 13 日发布的长文《当一个年轻人空降改造腾讯混元的 300 天》:29 岁的姚顺雨如何以 The Second Half 的判断选择腾讯、在 Martin 的信任下两三个月换掉预训练、后训练、评测与 Infra 全部关键岗位,再用一个接近 300B 的"小模型"混元 3 完成预期管理与团队磨合。播客补充了文章没展开的议题:混元与微信 VLM 两套大模型为何大概率长期并存,张小龙对隐私与可控的执念,腾讯联邦制组织与字节式"拧成一股绳"之间的张力,以及从 coding 到通用 agent 的扩散节奏决定 AI 商业化下一轮拐点何时到来。
本期晚点聊对话演语科技 Evoken 创始人陈冕。这家公司以 20 亿美元估值、单笔 3 亿美金融资成为"目前中国 AI 应用公司里最成功的那个",同时又是"最具有争议性的公司"——被质疑缺少原创度、靠激进定价换增长,甚至有投资人说它"迟早会爆雷"。陈冕用数据回应两个"神奇误解":公司现金流从 5 月起转正却被传爆雷,收入仅约 3-4% 来自投流却被说疯狂买量。他拆解了 LibTV"3.9 折"年包的健身房模式与定价算法,提出"阶段性低毛利"哲学(应用层毛利短期不超过 30%)。访谈回溯了他最接近死亡的时刻:与吐司的战争烧掉 300 万美金、投资到账那天账上只剩 4000 块、GPT-4o 发布让新流产品"赖以生存的土壤被刨"。他也完整讲述了自己的战略框架——三国战略(巨头逐鹿中原、创业公司一统江东)、时间换空间、用用户规模摆脱"地心引力"(模型厂商),以及对 AI 时代"idea is cheap、judgment 稀缺"的认知。这是一份关于"活下来"的极限生存手记。
晚点聊第 174 期,南齐对话 SAP 大中华区总裁原欣:从股价从 300 美元回落到 160 美元谈起,拆解 AI coding 对 SAP 几亿行代码的冲击边界——代码可以复刻、业务逻辑才是壁垒;SaaS 按座席收费的定价模式正在坍塌,向按用量、按结果(RaaS)迁移;模型即产品在 To B 不成立,财务场景 99% 准确率也不可用;FDE 热潮是 AI 从小圈子外溢到企业天地的必经路线,而组织惯性是比技术更大的挑战。最后落到中国企业的分化:88% 的企业在用 AI,只有 3% 觉得有业务回报——出来混总是要还的。
33 岁的姚颂用十年走完三段创业:清华电子系毕业后放弃 CMU 全奖博士,与汪玉、韩松创立深鉴科技, 见 50 家投资机构无人问津、被邓锋批评"纯技术人员的讲法",却在成立两年多以 3 亿多美元卖给赛灵思—— 签完约高兴了"两分钟"就陷入灰暗。在经纬做了一年 Venture Partner、用排除法筛掉四个方向之后, 他创立东方空间,把"好多快省"重排为好→多→快→省,让固体捆固体的引力一号首飞即成功, 还办了第一次民营航天发射直播。2025 年他第三次出发,带着正大、华勤两大场景创立 Striding AI(阵行创新), 坚定走隐空间+强化学习的路线:VLA"差不多走到头了",具身智能"肯定没到GPT-2的时刻", 但泡沫"没有想象中那么大"。从掐表学满 11 小时的大一新生,到"八分进攻,两分防守"的连续创业者, 这期节目是一个天才少年褪去光环、学会与自己和时代相处的完整记录。
Momenta 上市后,曹旭东再次接受《晚点聊》采访(六年里的第四次),复盘十年创业的判断与取舍:城区 NOA 市场上 Momenta 与华为合计市占率达 90%,智驾摩尔定律从两年十倍加速到每年十倍,2028 年城区 NOA 将达到 人类水平。他讲透了自己 2016 年靠量纲分析推出 1000 亿公里数据需求、从而选定飞轮战略的完整推演, 也首次详细解释 2027 年进入具身智能、2030 年家庭机器人拐点的判断依据,以及一个 World Model 支撑所有自动驾驶应用的底座逻辑。
本期「晚点聊」AI 季报迎来 26 年第二季度。Anthropic 的 Fable 5 被 Henry 评价为"史诗级能力、灾难级发布",OpenAI 的 GPT-5.6 用 TerminalBench 首次破 90 反攻;coding 市场经历从 Claude Code 到 Codex 的迁移潮与价格战,Anthropic 却在 Q2 实现首次盈利。本季最重要的叙事是 RSI(递归自进化)——Anthropic 发文《One AI Builds Itself》,Recursive、Merindale、Core Automation 等新公司批量涌现;中国开源模型八周内四次易主,Harvey 用 GLM 5.1 后训练出自己的模型;机器人与世界模型赛道 18 个月吸金超百亿美元,OpenAI 与 Anthropic 同步官宣机器人团队。Henry 从"推进前沿智能"与"加速智能扩散"两条线梳理全局,并讨论了预训练窗口、企业自有模型与 AI 研究的科学化。
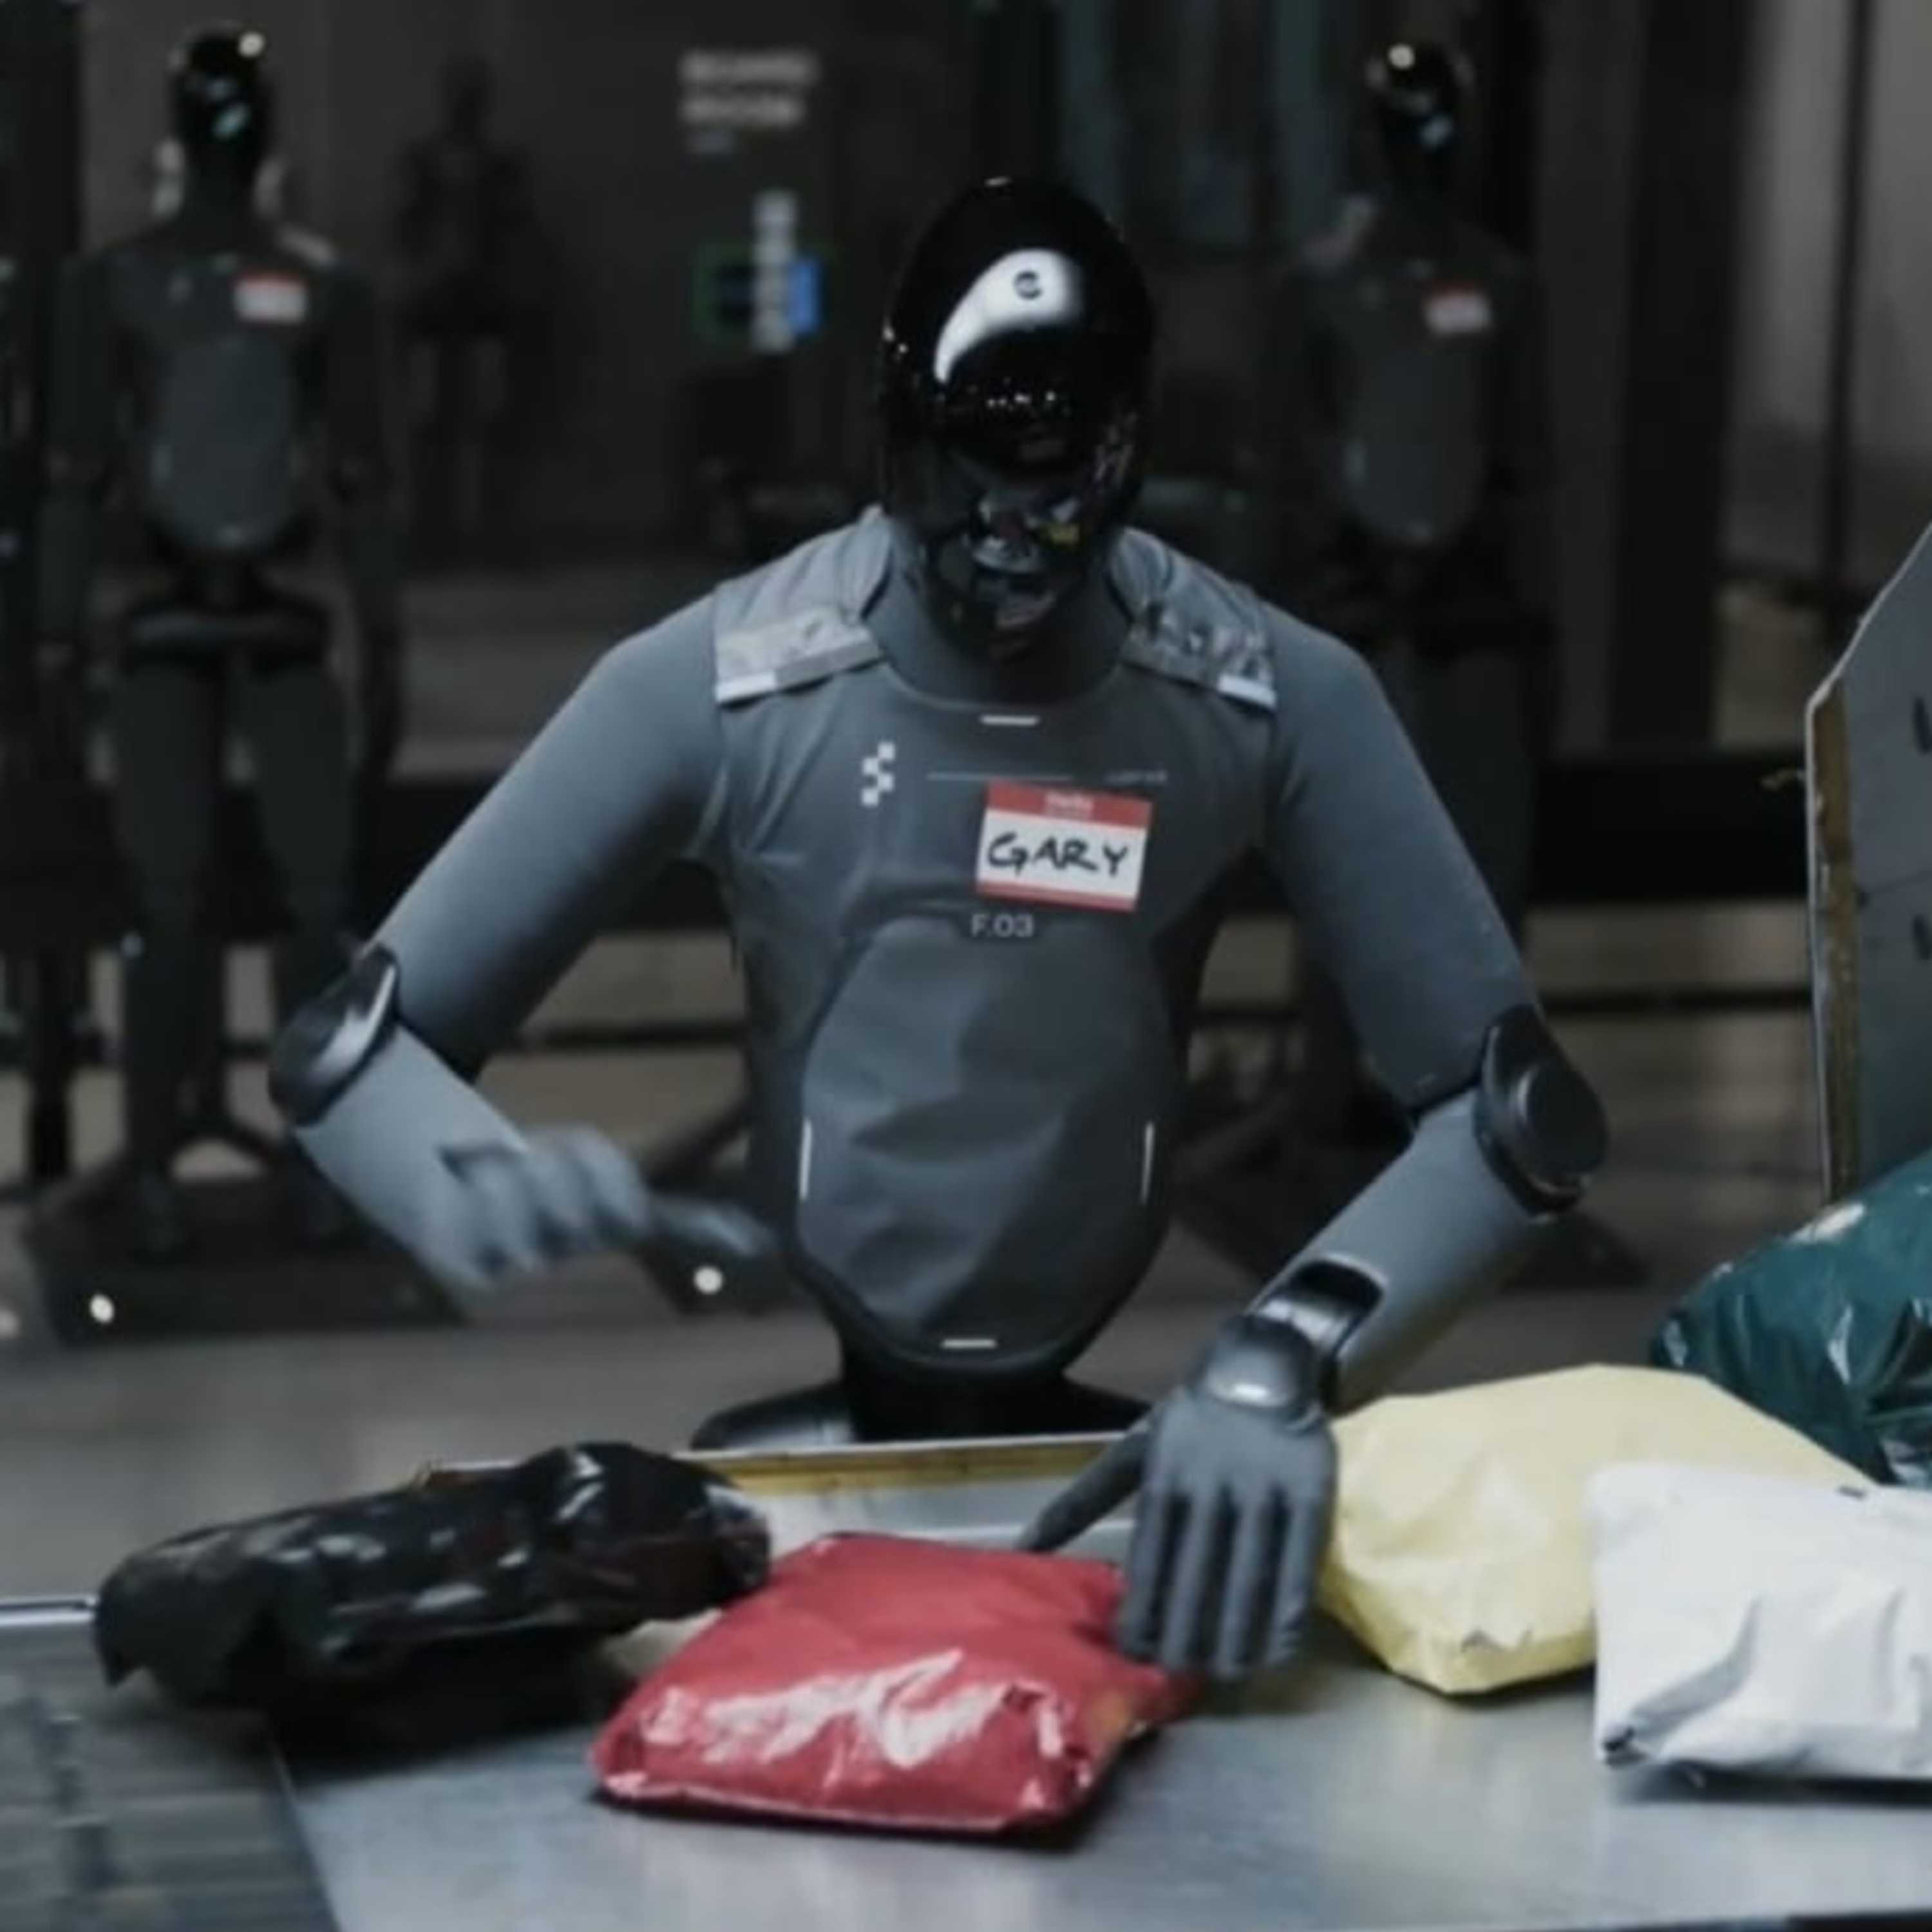
晚点聊「具身季报」系列第二期,AlphEast 创始合伙人陈哲(Peter)与主持人程曼祺复盘 26 年 Q2 具身智能 Top 5 进展:荣耀在亦庄人形马拉松包揽前三、Figure 直播分拣 13 万个包裹、五脊二代手领跑 ICRA 灵巧手竞争、英伟达发布全开源 Omni model Cosmos 3 掀起世界模型创投热、Pi 0.7 与 Gen-1 让 VLA 叙事继续延伸。节目还讨论了数据采集范式的演进、绳驱与直驱的技术路线之争、OpenAI 与 Google 的入局、具身模型的两极终局,以及大厂入场的"最后窗口"。
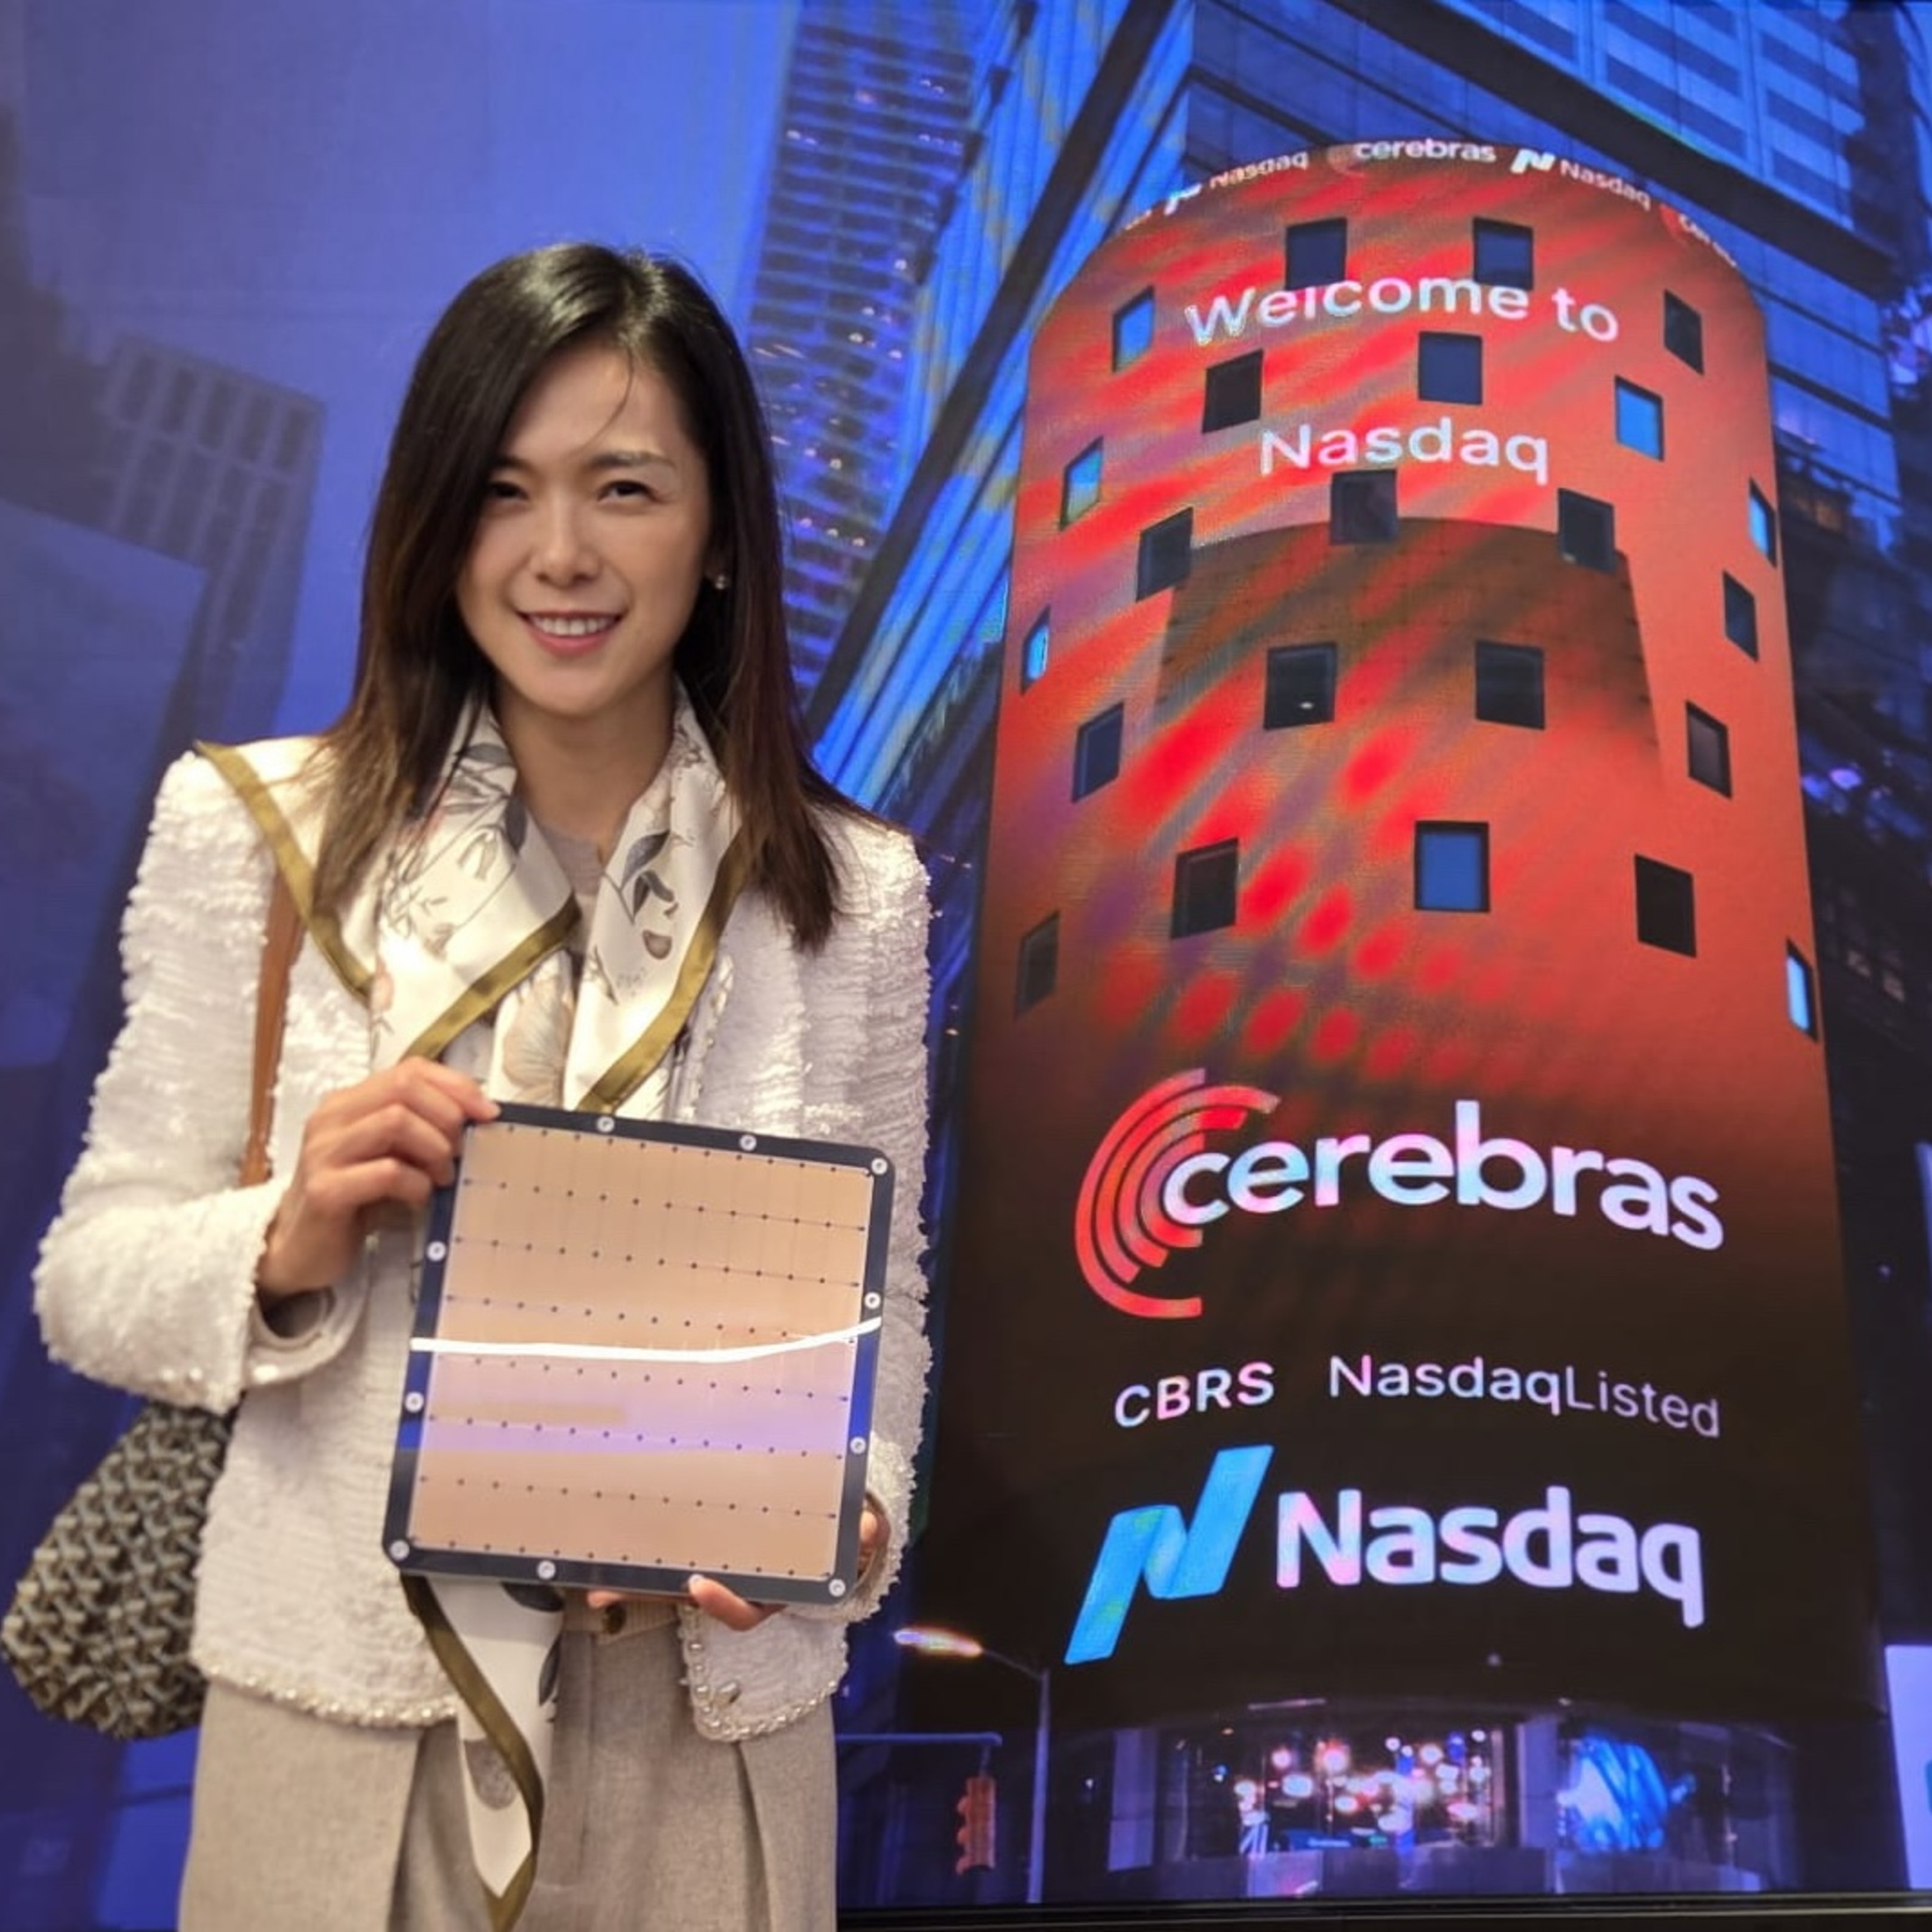
高通创投投资人周南回顾他十年前在百度美研完成的第一笔投资——Cerebras:从研究员的第一课 「不能只依赖英伟达这一个芯片」,到 2017 年以约 7 亿美元估值、两天通过投决的尽调全程。 节目也借 Cerebras 上市与 OpenAI 200 亿美元订单,讨论了算力从训练转向推理的大背景, 以及 Deep Speech 2 论文里 Scaling Law 的萌芽、百度美研这所硅谷黄埔军校的兴衰, 还有一只因中美地缘政治没能做起来的基金——OpenAI、Databricks 都曾躺在它的 deal list 上。
美团龙珠合伙人王兴宇回顾十年科技投资生涯:从 GGV 三年学徒、2018 年 AI 低谷期在昆仑万维投出 pony.ai(16 亿美金估值、当时全世界最高),到 2021 年加入美团龙珠建立「三横三纵」科技投资框架,重注月之暗面(3000 万美金、龙珠大模型唯一标的)与宇树(最大外部股东)。他详述了 NeurIPS 之行对具身智能的「开窍」、「拦腰斩断」的机器人投资框架、2025 年范式的判断,以及「AGI 已经实现」的标准——今天的 AI 已超过 80 亿人的平均水平。
洋葱学院联合创始人兼 CEO 杨临风做客晚点聊,讲述这家 13 岁教育科技公司如何用 5-8 分钟动画视频推动学生自主学习:1.3 亿注册学生、400 万注册教师,却从没做过直播课与拍照搜题,2022 年全年打平。面对 AI 热潮,他认为纯大模型还讲不透中小学的系统二学习,教育交付的是过程而非结果;洋葱把 AI 当作规划器与策略分发器,与公立学校共建"师生机三元课堂"。
许华哲在离开星海图后再次创业,成立破壳机器人,目标是把通用智能(physical AGI)送进家庭。 他判断未来 18-24 个月会有一台机器人真正走进家里做事,并主张具身智能应该走 AI native 路线: 不是传统机器人学、不是自动驾驶、不是史前深度学习,而是统一大模型加全部数据加规模化后训练。 节目还聊了他对行业"卖数据、无脑量产、跳舞"三大现象的批评,以及从科学家到创业者的人生转变。
高深远(港科大博士、NVIDIA GEAR Lab 成员)从自己研究世界模型三年的视角,先把"世界模型"拆成决策派与知识派、再按表示方式分成粒子、显式 3D、隐空间与视频四个流派,论证视频空间是当前最 promising 的路线。随后他展开 GEAR Lab 的 DreamDojo 与 DreamZero 两项工作:前者用约 4.4 万小时人类第一视角视频给 action-conditioned 世界模型迁移泛化能力并做到实时,后者以视频为 backbone 把 VLA 策略与未来状态预测合二为一。最后他解释了由 agent、policy 与世界模型构成的自进化循环,为什么他认为这个循环今年可能出现临界点、但真正爆发需要五年,以及评测没有 zero-shot benchmark、长程记忆缺失等现实瓶颈。
明略科技创始人吴明辉在 OpenClaw 掀起个人 Agent 热潮后,宣布 SaaS 行业已死:闭源软件分分钟被 AI 复刻,明略转向开源 + Agentic Service(结果即服务)模式。节目中他详细拆解了把 OpenClaw 从个人助理改造成团队协作者的实践、多只专长龙虾在群聊里产生集体智慧的章鱼 Octo、品鉴者体系与龙虾商业伦理学,并复盘了 2020-2022 年千人大团队做组织智能(EIP)最终裁员一半的教训。他给出的终局判断是:基模 Scaling up 到今天已经足够,下一步是靠 Scaling out(集体学习与组织智慧)和人的 Taste 取胜。
DeepSeek V4 发布后,晚点聊邀请两位一线 AI 从业者——UCLA 博士生刘一峰与 sglang 核心团队 RadixArc 的赵晨阳——逐层拆解技术报告。V4 并非新范式,而是在 R1 的测试时扩展范式下,通过混合稀疏注意力、Muon 优化器、MHC 结构、Triton 与 FP4 四组互相耦合的组合创新,把百万上下文从"理论可行"推进到"成本可接受"。节目同时讨论了 3% 的极致激活比例、FLOPs 降到 27% 的效率革命、训练成本数字的消失、token 浪费的行业隐忧,以及中美两种模型路线的差异。
飞书深诺创始人兼 CEO 沈晨岗与晚点聊主播洪浩聊 AI 时代的出海营销:2025 年起中国出海 从 1.0 的"卖货"进入 2.0 的产品与品牌阶段,竞争沿价值链向上攀升。他拆解了 DMES 衡量模型、 AI 在营销行业的共识与非共识、创意生产的 agentic flow 与春节 6000 条创意案例,也解释了 为什么飞书深诺对 AI Agent 保持克制、以及"数字化原生 + 每天两千万美金数据沉淀"的护城河。
唐文斌回顾了从信息学竞赛、旷视创立到物流机器人业务的十五年经历,解释技术团队如何从体感游戏转向 Face++、身份认证和仓库机器人。他也分享了原力灵机对具身原生模型、真实使用数据、场景闭环和模块化硬件的判断,并把新公司的阶段目标落在一个可持续运行的真实场景上。
黄晓煌回顾群核从 2011 年把 GPU 做到云上,到用酷家乐找到设计师和装修公司的付费场景,再到大厂竞争、行业周期与多次业务转向。访谈的后半段聚焦空间智能,解释 SpatialLM、SpatialGen、真实与合成数据,以及群核为何选择三维模型作为连接大语言模型和物理世界的路线。
张璐从 TeraFab 的 1 太瓦级算力设想出发,分析了太空数据中心在辐射、延迟、发射和维护上的现实约束,也解释了马斯克把芯片、算力、模型与物理世界放进同一生态的长期意图。谈话随后转向英伟达的 AI 工厂、异构计算和推理负载,以及金融、医疗等高监管行业对本地小模型的需求,最后落到 AI 基础设施创业、企业级商业化和并购退出。
这期 Solo 讨论 V4 发布前的 DeepSeek:近期少量研发人员流动,如何与 AI 人才竞争、期权定价和 V4 的等待交织在一起。节目也拆解梁文锋对 AGI 的理解——除了提高模型智能上限,还要建设国产生态、投入回报不确定的原创方向;与此同时,产品触点、Agent 竞争和算力约束正在重新定义这家公司的压力。
陈哲从宇树春晚表演和招股书出发,解释人形机器人的进展为什么首先体现为本体、运控和量产一致性,而不是一段好看的视频。对谈继续讨论高自由度灵巧手、触觉、世界模型、数据金字塔与端侧算力,比较中美公司在硬件供应链和模型资源上的不同位置。 这期季报没有给人形机器人下定论,而是把几个仍在变化的变量摆在一起:形态是否必要,世界模型能否超过 VLA,触觉数据如何积累,以及上市潮会如何筛选真正能交付的公司。
Henry Yin 从 OpenClaw 的个人助理形态出发,分析 Claude Code、Codex 与模型厂商如何把竞争推进到产品、生态和企业部署层面。节目也讨论了 Auto Research 所代表的自进化实验、持续学习的技术边界,以及 Agent 对推理基础设施、组织配置和劳动市场的影响。
贾鹏回顾了自己从高性能计算、NVIDIA 自动驾驶团队到理想汽车辅助驾驶的经历,并解释这些经验如何塑造至简动力的创业选择。对他而言,具身智能的难点不只在模型和数据,更在于可量产硬件、真实场景数据,以及把基础模型变成高可靠单一任务的完整链路。
高岱恒从千问团队变动后的人才搜索变化讲起,解释开放模型如何借由模型社区、论文与开发者反馈形成影响力。他也回顾自己的开源经历和 AI 研究者故事,并讨论了以公开作品发现人才、以 Agent 改变招聘与任务协作的可能性。
韩峰涛从上一轮工业机器人创业的市场教训出发,解释千寻为何把数据与具身基模放在短期营收之前。他认为 2026 年的关键是扩大真实数据采集、提高模型基本能力,并用少量现场项目寻找可复制的落地路径。
陈宇森解释了为什么 MuleRun 从 Agent Marketplace 进一步走向 Agent Builder:Claude Code 让自然语言描述、技能和运行环境能够被打包成可执行的工作流,长尾需求因此有机会成为软件。访谈也记录了他从长亭科技到游戏与数据安全创业的起伏,以及他如何把用心和快速验证重新放回创业方法中。
曼琪以 2025 年的模型进展、Agent 应用、巨头竞争、创业融资、具身智能与 AI 硬件为线索,回顾技术如何进入产品和组织。 节目也把视角放回使用者:当工作内容与人才市场被重写,人如何在效率变化中保留经验、关系和意义感。
范浩强与高阳从 RoboChallenge 的 Table30 出发,讨论具身模型为何难以在真实世界中公平测评,以及少样本微调与零样本评测分别回答什么问题。对谈还梳理了数据规模化、单帧模型的记忆缺口、演示可信度和机器人商业化所需的能力门槛。
陈亦伦从 2021 年自动驾驶端到端实验讲起,解释为何他把运动控制、大模型任务规划和端到端学习视为具身智能的三道曙光。访谈的重心落在数据:它石智航希望用可穿戴手套和第一视角相机,在真实工作场景中记录人类操作,再让模型学习空间、接触与力的变化。团队计划先在工业制造等已有大量人工操作的场景检验技术价值。
OiiOii 创始人闹闹回顾了从动画爱好者、内容创业者到剪映和抖音特效产品负责人的经历,并解释为何在 AI 时代先做动画创作工具。团队把可编辑的多 Agent 工作流和模型编排用于 PUGC 创作者,目标是先积累多样内容,再走向能够留住用户的内容社区。