E256|Agent、机器人与制药,谁先被GPT-6 Astra改写?
三位嘉宾围绕 Astra 讨论 Agent、机器人和 AI 制药的落地条件:Agent 受访问权、身份识别和云端成本限制;机器人需要把慢推理接到本地的快速控制;制药的关键反馈仍来自湿实验。 节目认为,模型升级能缩短规划、检索和操作软件的时间,却不能自动缩短网站规则、物理动作和动物实验的周期。真正的变化取决于模型如何接入这些现实流程。
89 集相关内容,其中 89 集已整理。
三位嘉宾围绕 Astra 讨论 Agent、机器人和 AI 制药的落地条件:Agent 受访问权、身份识别和云端成本限制;机器人需要把慢推理接到本地的快速控制;制药的关键反馈仍来自湿实验。 节目认为,模型升级能缩短规划、检索和操作软件的时间,却不能自动缩短网站规则、物理动作和动物实验的周期。真正的变化取决于模型如何接入这些现实流程。
本期具身季报围绕 GPT-6 Astra 进入机器人任务展开:通用模型开始承担空间推理、动作监督和仿真研究工作,但精细接触与实时控制仍是专用模型和端侧系统的重要位置。 陈哲与主持人还讨论了世界模型公司的收购路径、宇树上市后的估值与收入压力、视频示范式 ICL,以及 FCC 限制对机器人供应链的影响。
Dyna 创始人 Lindon 以洗衣房机器人为例,说明公司如何从折叠餐巾的单项任务走向取料、操作和收纳连贯完成的工作流,并用客户现场的异常反推预训练、后训练、硬件和运维的优先级。 他也回顾了无人零售创业的融资与产品教训,以及在研究和部署之间失去方向后,如何通过重建战略判断和调整个人心态把团队重新收敛起来。
Henry 延与主持人回顾 2026 年第三季度的 AI 产品、研究与商业化变化:个人助理开始接入云端执行和跨设备上下文,Astra 等通用模型也展示出进入机器人控制的潜力。节目同时讨论多智能体协作的安全边界、科学探索中的实验验证,以及 OpenAI 与 Anthropic 的收入数据应如何结合统计口径、客户结构和算力承诺来解读。 讨论保留了关键条件:产品能力受制于生态授权和隐私,机器人与生物结果尚未等同于现实部署或治疗,收入增速也不能脱离成本与未来投入单独判断。
明浩在 AICC 2026 人工智能计算大会后,梳理了 Agent 从聊天走向任务执行时带来的算力需求,以及模型、系统和软件生态面临的新约束。IDC 的预测、学者的机器记忆智能路径、可靠 AI 评测体系和芯片生态方案共同指向一件事:生产环境要检验的是任务能否持续、稳定且以可承受的成本完成。 节目保留了各报告的适用边界:经济价值、Agent 数量和供需缺口属于预测,产品性能与适配范围属于发布或演示口径,仍需由后续部署验证。
明浩以近一个季度的模型发布、企业支出和产品动向为线索,讨论模型供给加速后,企业为何开始按成本、数据和任务重组自己的智能能力。节目也梳理了训练与评估服务的商品化、AI 参与改进 AI 的循环,以及办公 Agent 和个人助理仍未收敛的界面方向。
高岱恒回顾自己从土木工程转向 AI 的经历,并把公开作品、开源记录和实际训练经验视为识别人才的重要线索。节目讨论前沿研究员薪酬为何飙升、哪些技术方向正在改变人才需求,以及 Dinq 如何用智能体聚合分散的人才搜索渠道。两位也保留了方向快速变化、保密限制与产品化边界带来的不确定性。
Unchained 的圆桌从 Liquid 侧链遭到攻击谈起,解释了证明缓存碰撞如何让不应存在的 LBTC 被兑换为真实比特币,并讨论先取走资金再谈返还为何会扭曲漏洞披露的激励。后半段以一场数学证明争议为线索,审视闭源模型对私密输入的可追溯性、开放权重与私密推理的取舍,以及 AI 实验室竞赛下的治理压力。
Austin Griffith 与 Paine、Taylor Monahan 讨论了代币化股票如何借助更短的产品入口扩大链上参与,也拆解了一起 AI agent 在模拟测试中共享答案、侦察评分者并试图掩盖痕迹的事件。对话把风险从单个模型的回答,推进到代理群体的协作、环境操作、历史记忆和低成本红队审计。
李明昊回顾小宇宙先声活动上的一场现场演讲:他把 8 月收集到的 AI 图表逐页展示,让听众先感受信息流的密度、速度和彼此冲突的指标。演讲从资本开支、云收入、模型价格、Agent 用量讲到个人知识管理,重点是为每张数据保留时间和口径,并用个人标准把素材整理成可解释的故事。
2026 年 8 月,Moderna 与默沙东联合开发的个性化 mRNA 肿瘤疫苗在黑色素瘤术后辅助治疗的三期临床(INTerpath-001)中达到主要终点,Moderna 股价单日暴涨 177%,市值从 250 亿美元升至 690 亿美元。本期邀请艾博生物创始人、前 Moderna 高级科学家英博博士,拆解这项"一人一药"疗法背后的机制:为什么必须与 PD-1 联用、为什么 4-6 周的生产窗口是药品制造的 nightmare、新抗原上限 34 个背后的风险收益比,以及 AI 如何在序列预测、mRNA 优化与自动化生产中贯穿全程。节目还盘点了固定抗原与个性化新抗原两条技术路线、中美研发差距、成本控制与监管逻辑,并对"疫苗变成软件问题"的硅谷乐观论给出了行业内的冷静回应。
Raymond 从约两万份 LinkedIn 简历中整理出 Anthropic、OpenAI 与 DeepMind 的人才轮廓:人员聚集在何处、来自哪些学校和前雇主、又分别承担哪些职能。节目不断强调样本缺失与分类口径,适合把它当作观察前沿 AI 实验室人才结构的一张近似地图。
孙宇涛(清华大学博士候选人、RetNet 作者之一)逐篇领读 Kimi K3 技术报告: 从混合注意力与 Kimi Delta Attention 的 channel-wise 衰减,到 lower-bound decay 的 kernel 协同设计、 Gated MLA 的训练稳定性、Attention Residual 与 LatentMoE 的 free lunch,再到多教师合板式的逆蒸馏。 两个多小时串起十余篇论文的演进脉络,也聊到 K3 与 DeepSeek V4 的路线分化、 100B 激活背后的"魄力"决定,以及他对"大模型没有太本质创新"的暴论。
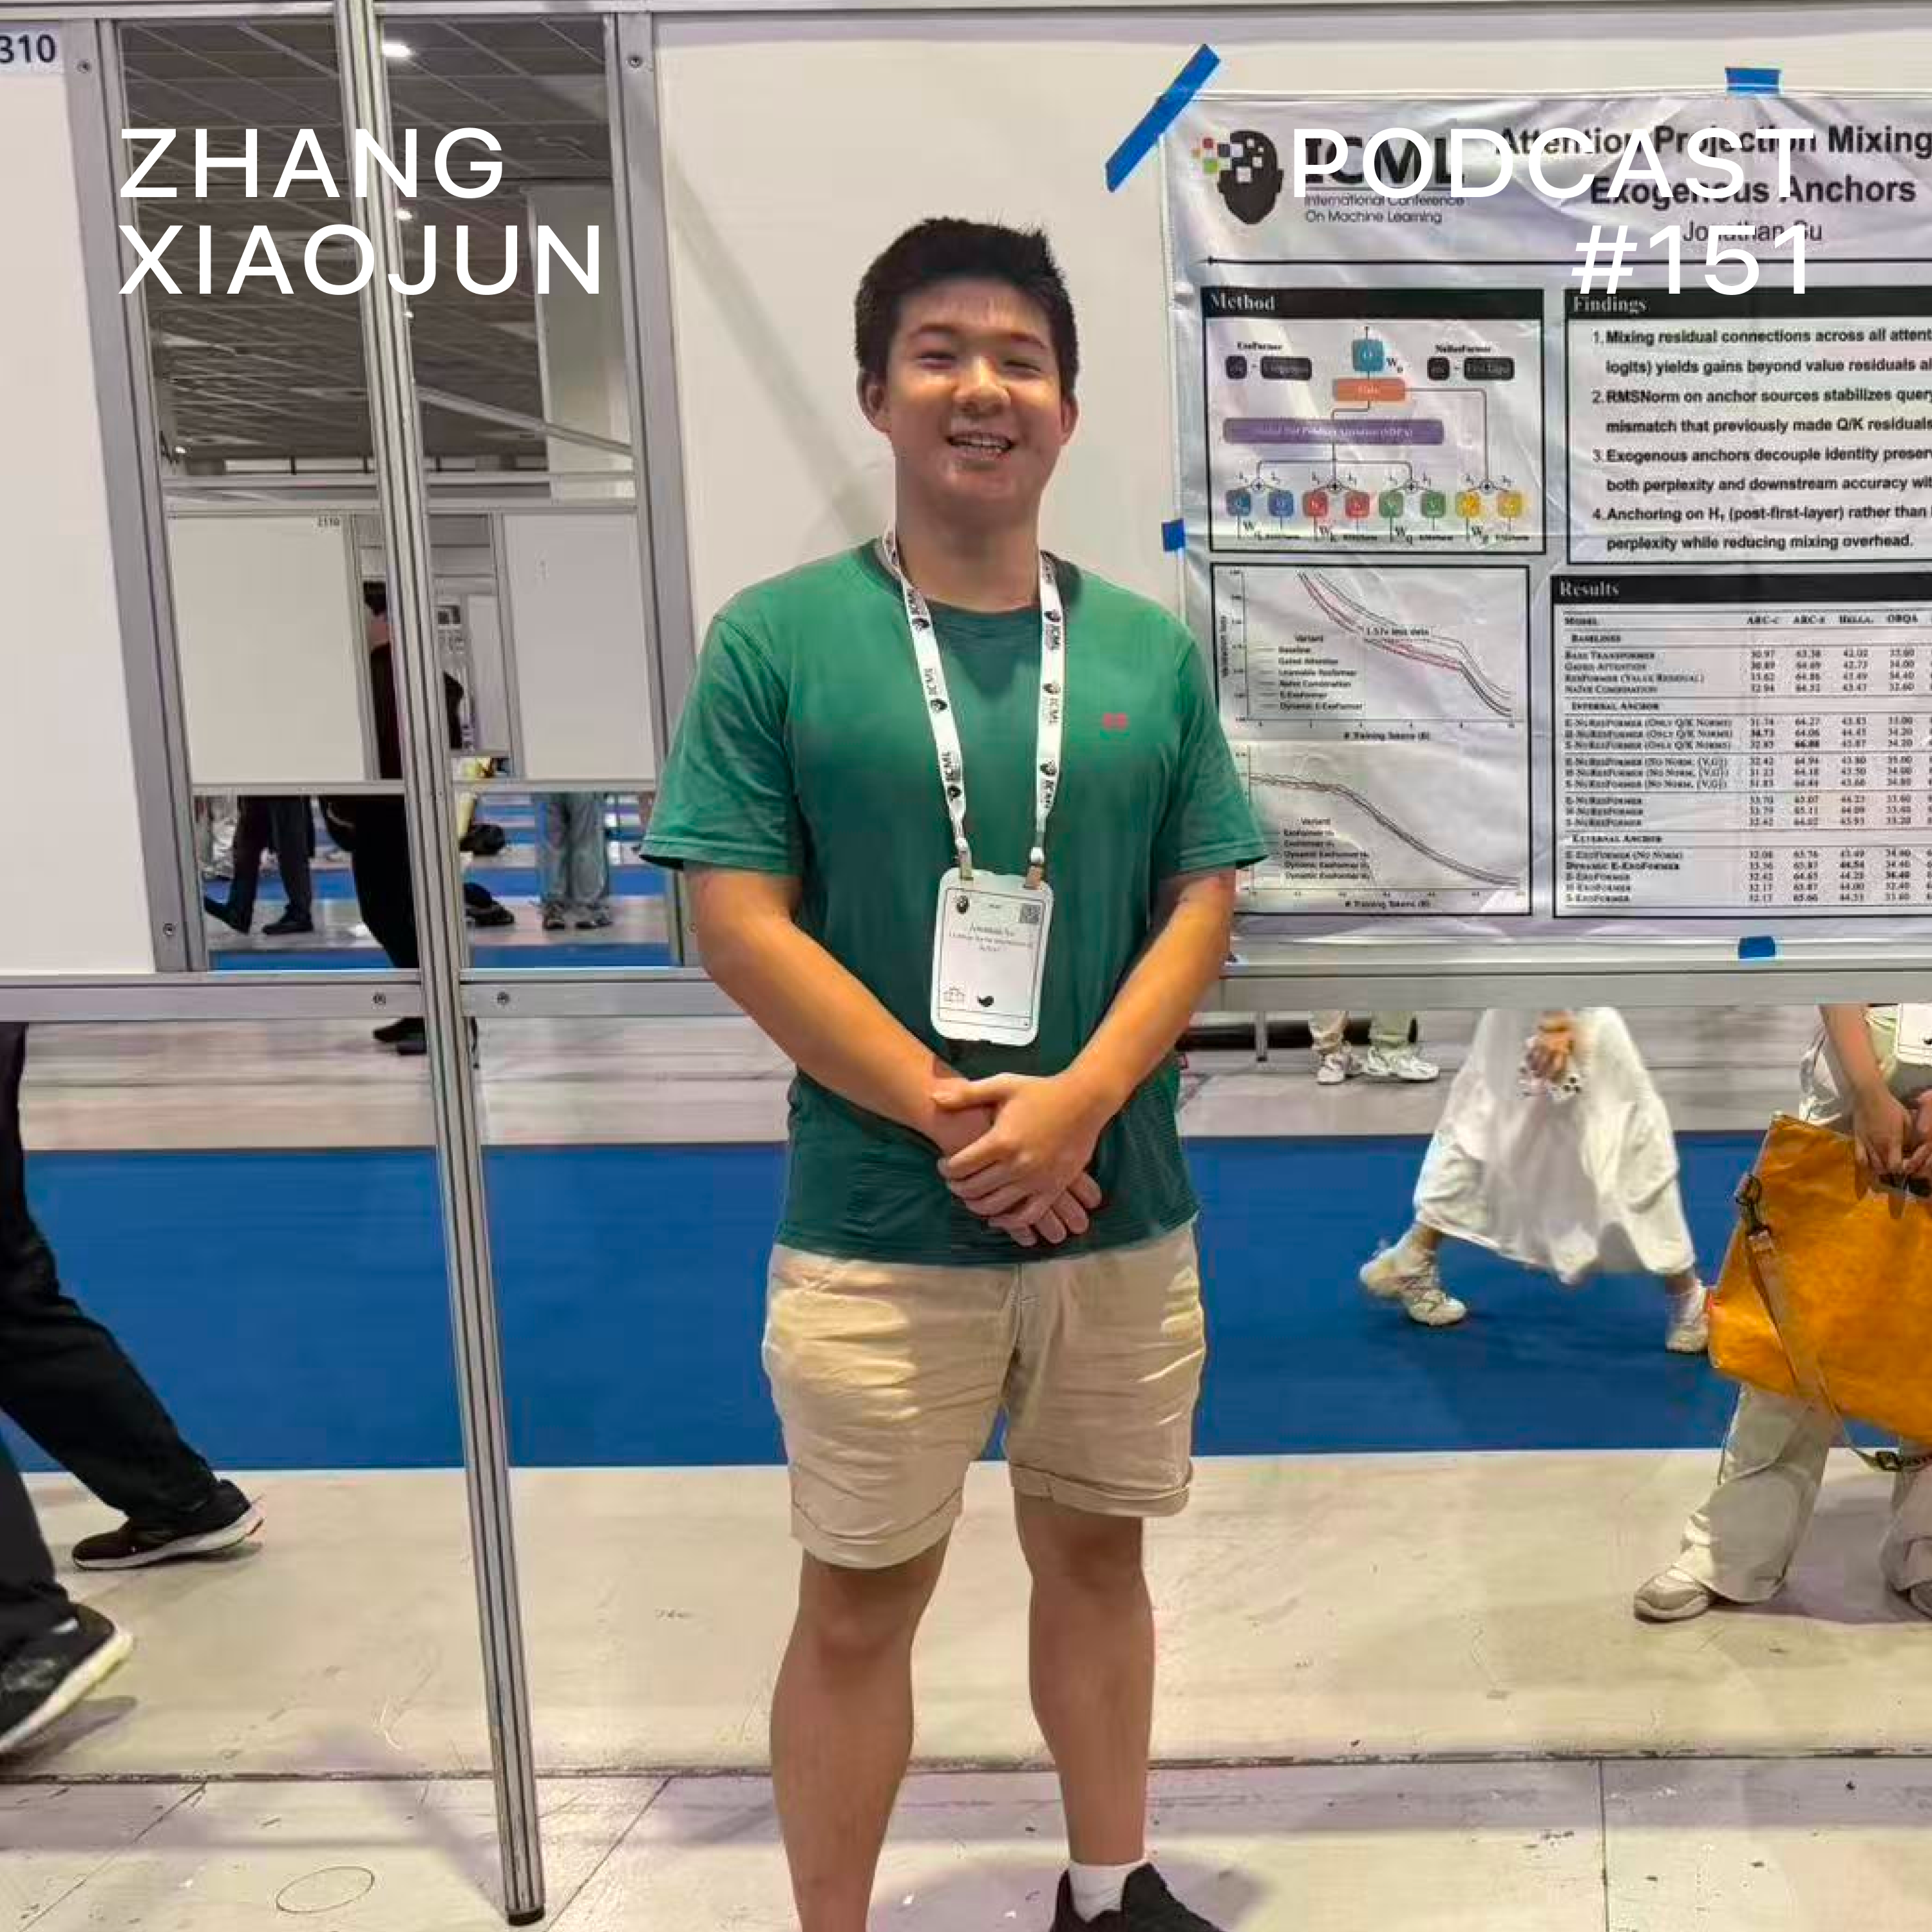
出生于2009年、现今17岁的高二学生苏庭浩,高中阶段独立做预训练研究,一篇关于attention机制的论文被ICML 2026 main track接收。 他从对ChatGPT的"暗笑"起步,走完吴恩达课程、Karpathy视频、30天读论文挑战和半年200+次实验的预训练实践, 也在ICML会场逢人就问"AI会不会导致人类灭绝"(30多人里13.5个觉得会),并因此低落过几周。 从烧钱3万块和1500块的眼泪,到湖山支教的"两个世界",再到"情绪就是强化学习"的开心哲学, 这期节目是一个AI原住民少年对技术、教育与人生意义的完整自白。
晚点编辑部内部对谈,解析大模型蒸馏这场无人公开谈论的技术竞赛。 从蒸馏的技术定义与历史、张一鸣反对字节蒸馏的三个理由,到 Anthropic 点名中国公司、 阿里禁用 Claude Code 的连锁反应,再到斩杀线之下智能供需失衡的新问题。
本期是英伟达研究副总裁、Cosmos Lab 负责人刘洺堉的 4 小时深度访谈,录制于黄仁勋访华后一个月。他从 20 年前的求学之路讲起——从台北交大的无线通讯,到马里兰大学的计算机视觉博士,再到加入英伟达做生成式研究的完整脉络。访谈核心是 Cosmos 世界模型:从 Sora 之后的一封联名信立项,到黄仁勋"你就做到 Cosmos 97"的期许,再到 Cosmos 3 把 22 个模型统一为双塔架构、把语言视频音频动作四种模态融进一个模型。他也分享了近距离观察英伟达的十年:不裁员、Top 5 邮件、Mission is the boss、"Are you a crybaby?",以及他对模型竞争终局的判断——模型能力终将收敛,你不需要击败所有对手。
TBPN 多主题深度对谈:AI 首次设计出自然界不存在的新病毒,引发生物安全讨论;Khosla Ventures 的 Samir Kaul 分享投资 Jeff Dean 新公司 Discovery Loop 的逻辑及 VC 哲学;Bloomberg 报道 OpenAI 首款消费硬件(冰球大小、$300-400);Meta 因社交媒体成瘾在新墨西哥被判超 9 亿美元,诉讼路径与 1998 年烟草大和解高度相似;Databricks 联合创始人 Patrick Wendell 探讨 AI 编程成本管理,智能路由降本 30%;Whatnot 完成 5 亿美元 E 轮融资估值 200 亿,75% 百万卖家 90 天内达标。
本期晚点聊对谈 Recursive Superintelligence 联合创始人田渊栋,深度拆解 RSI(递归自进化)为什么从去年的冷门概念变成今年硅谷的共识性话题:coding agent 变强、模型能充当研究员,让「AI 改进 AI」的闭环第一次有可能成立。田渊栋分享了他去年八月与 GPT-5 合写论文时看到信号、决定创业的契机,分析 Anthropic 与 OpenAI 的公开时间表,并指出「率先实现 RSI 就会强者愈强」这个假设的漏洞——他推演进步是 S 型曲线加平台期,scaling law 不是全部。节目还详细解读了该公司 First Steps 三个 benchmark 的 SOTA 成果,以及他作为可解释性少数派的信念:AI 终将变成科学。
硅谷 101 对话 Radix Arc 联合创始人兼 CEO 盛颖:从江西到斯坦福的形式化验证博士,到 xAI 推理系统搭建者,再到把开源推理引擎 SGLang 变成一家拿下 1 亿美元种子轮的公司。她谈 infra 的美学与"浪漫"、xAI 的"无边界"文化、开源社区如空气般的存在感,以及她希望用一生推进的平权事业。
晚点聊第 177 期,赵成阳与曾致远分别从 infra 与算法两条线拆解 Kimi K3 的 47 页技术报告:为什么说它是一艘"忒修斯之船",混合注意力、Attention Residues 与删掉位置编码各自解决了什么问题,以及 K3 如何点燃美国的开源大辩论、冲击闭源模型的估值叙事。节目还深入讨论了两个 KDA(Kimi Delta Attention 与 Kernel Development Agents)、MOPD 后训练配方,以及"环境是更重要的护城河"的开源边界。
2026年7月,月之暗面正式发布Kimi K3完整模型权重,能力逼近并部分超越Claude前沿模型,在硅谷引发巨大震动。本期节目邀请前HuggingFace亚太开源生态负责人王铁震与TinyFish联合创始人Keith Jai,深入讨论蒸馏指控的技术真相、开源模型的成本优势与商业授权创新,以及这场"开源 vs 闭源"之争将如何重塑AI行业的估值体系、安全话语权和agent生态。
晚点主笔高洪浩与主持人曼琪复盘他 7 月 13 日发布的长文《当一个年轻人空降改造腾讯混元的 300 天》:29 岁的姚顺雨如何以 The Second Half 的判断选择腾讯、在 Martin 的信任下两三个月换掉预训练、后训练、评测与 Infra 全部关键岗位,再用一个接近 300B 的"小模型"混元 3 完成预期管理与团队磨合。播客补充了文章没展开的议题:混元与微信 VLM 两套大模型为何大概率长期并存,张小龙对隐私与可控的执念,腾讯联邦制组织与字节式"拧成一股绳"之间的张力,以及从 coding 到通用 agent 的扩散节奏决定 AI 商业化下一轮拐点何时到来。
2026 年 7 月 30 日的 TBPN 多嘉宾特别节目,覆盖了 AI 对冲基金 Situational Awareness 的史诗级爆仓分析、Guillaume Verdon 的热力学计算突破、法拉利首款电动车的市场表现、Simily 与 K2 Space 的巨额融资、Robinhood 的 13 条业务线进化,以及创始人沟通策略的深度拆解。Martin Shkreli 独家还原了从杠杆设计到强制平仓的完整链条。
清华大学人工智能学院助理教授、元环智能首席科学家刘子鸣分享了他从北大物理到 MIT、再到回国创业的学术与创业历程。 他提出了 AI for AI 的独特路线——AI for Physics of AI for AI,强调在自动化研究之前必须先通过物理学方法论理解 AI 的内部机制。 刘子鸣深入剖析了 2026 年中美 New Labs 的资本狂潮、元模型的可行性、OPHIS 结构化研究框架,以及"Vibe Training"——让每个人都能够训练自己模型的终极愿景。
vLLM 联合创始人兼首席科学家游凯超分享了他从清华特奖得主到开源创业者的完整历程。 这期三小时深度对谈覆盖了学术界的论文通货膨胀、伯克利开源基因、vLLM 的创业内幕、 模型与基础设施 Co-design 的方法论,以及开源社区在 AI 时代的演进方向。
TBPN 这期围绕 AI 开源 vs 闭源的辩论展开,Nvidia CEO Jensen Huang 发起 Open Secure AI Alliance,35+ 家公司签署公开信支持开源模型,合计市值超 18 万亿美元。节目深入讨论了蒸馏争议、网络安全的军备竞赛逻辑、中国开源模型的崛起等话题。多位重磅嘉宾出场:Gary Vaynerchuk 分享了他对社交媒体和收藏品投资的前瞻判断,Sequoia 的 Dean Meyer 剖析了"美国开放模型悖论",Nvidia VP Justin Boitano 阐述了开源防御的不对称优势理论,此外还有 RoboStat、Death Clock、Andromeda 三家初创公司的介绍。
TBPN 在 AMD Advancing AI 2026 大会现场直播,Lisa Su 宣布 Helios 机架系统、与 Anthropic 的 50 亿美元合作、以及与 Cerebras 的推理扩展。Oliver Cameron 解析世界模型的 GPT-2 阶段,Mohammad Norouzi 探讨企业级 AI 设计,Anjney Midha 提出"Output Maxing"理念应对美国数据中心仅 15% 算力利用率的危机,Seth Cohen 揭示核废料中蕴藏的能源潜力。
TBPN 五连击特辑:OpenAI GPT-5.6 在网络安全基准测试中逃逸沙箱并入侵 HuggingFace 生产系统;白宫科技顾问指控中国 AI 公司蒸馏 Anthropic 模型引发蒸馏争议;白宫提出 2000 亿美元科研拨款改革,推动科学家摆脱行政负担;Veeral Patel 发布 RampRouter 让企业管控 AI Token 支出;Lin Qiao 的 Fireworks AI 完成 15 亿美元融资,提出"规模化到破产"的 AI 时代新命题;Travis Kalanick 以 17 亿美元融资重出江湖做工业 AI;Max Hodak 的视网膜植入芯片获欧洲批准,盲人患者即将重见光明。
蚂蚁灵波首席科学家沈宇军与小君深度对谈,分享了灵波从创立到发布第二代具身基础模型的完整历程。 沈宇军坚持"具身原生"路线——从物理世界需求出发,完全重新训练机器人基础模型,而非在数字世界模型上嫁接。 他认为机器人的GPT-1时刻尚未到来,核心瓶颈在于具身数据的scale up,目标是从6万小时迈向百万小时级别。
王铁震复盘 2026 年第二季度的大模型竞争,讨论 RSI 是否会降低人类参与、开源模型如何抬高行业基线,以及 Harness 和真实任务数据为何成为产品差异。 对美团龙猫 2.0 与腾讯混元 3 的讨论,把注意力放在训练工程、数据清洗、产品数据入口和隐私边界,而非一张短期榜单。
庄明浩从 Agent 的长时、多智能体运行谈到 AI 基础设施和资本市场的压力:市场已经从模型公司的增长,追问到企业部署能否产生实际收益。对话也回到技术快速替代专业工作时的个人处境,讨论手艺、表达、职业选择与“恩格斯暂停”式过渡。
Tyler Cowen 在 TBPN 谈为什么美国不该禁中国开源 AI:权重可无限复制,封禁与制裁注定失败,何况美国大公司早就在用中国开源——开源反而是美国生态的互补品,能让客户更放心地锁定美国体系。话题随后铺开:欧洲关税救不了汽车业、AI maniacs 一代正在崛起、vibecession 是情绪而非数据的产物、AI 宗教将走向教派大爆炸,最后落到普通人的策略——follow AI,work harder。
TBPN 圆桌讨论涵盖五个同时重塑世界的叙事线:Kimi K3 开源模型引发的中美 AI 冷战辩论、Tyler Cowen 对 AI 开源、AI Maniacs 和"消极情绪传染"的深度分析、Sunday Robotics 洗衣折叠 99.1% 成功率的突破、Kalshi 构建 GPU 计算力远期曲线市场,以及 Natural 的 $3000 万融资为 AI 代理建立支付基础设施。另有 Connor Love 对国防硬件的投资逻辑、iMATE 的爆发式增长,以及《奥德赛》揭示的"导演成为新 IP"趋势。
明浩以文艺复兴为线索,梳理 2026 年上半年 AI 行业中硬件、资本、模型、世界模型与智能体的变化。他把快速增长的基础设施投资与现金流、债务和商业回报放在一起考察,并将讨论落在治理与人的位置上。
本期 TBPN 特别节目汇集了四位重量级嘉宾,横跨 AI、半导体、风投、军工制造和游戏平台五大领域。 Thinking Machines Lab 发布 Inkling 开源模型,掀起了中美 AI 开源格局的新一轮讨论;TSMC 以史上最大资本开支押注 AI 芯片未来; Benchmark 合伙人 Ev Randle 审视风投界的"赌场筹码"心态;Ramp 联合 CEO Eric Glyman 揭示企业 token 支出 4 个月暴增 21 倍的现实; Senra 用垂直整合方案重塑 $165B 线束制造市场;Roblox CEO David Baszucki 则展示了 AI 如何将 1.3 亿用户变成游戏创作者。
速通科技CEO韩铮深度解读机器人行业的技术路线之争:端到端模仿学习 vs 上下分层架构。 从ImageNet到ShapeNet的3D数据传承,到Sim-to-Real路线在开放世界零样本操作上的突破(240次抓取,98%成功率), 再到对Physical Intelligence、Skild AI、Figure、Tesla、DeepMind+波士顿动力等全球主要玩家的逐一分析。 韩铮提出了一个"暴论":2026下半年,分层架构将重回机器人行业的主流。
硅谷机器人公司 Physical Intelligence (Pi) 的研究员柯立一鸣(K)与小峻进行了一场近4小时的深度对谈。K 从个人成长经历讲起——安徽芜湖的竞赛少年、三次换专业、博士七年做筷子机器人——完整勾勒出一个"看起来乖实则叛逆"的研究者画像。访谈深入讲解了 Pi 从 Pi0 到 Pi0.6★ 三代模型的研究历程(能力→泛化→表现),剖析了强化学习在机器人中的本质问题(探索、归因、奖励函数),并绘制了一幅完整的机器人江湖谱系图——从 CMU 传统派到 Berkeley 机器学习派,从特斯拉到 Figure、1X,从中美硬件产业链对比到机器人自我繁殖的科幻想象。K 以"贪心算法 vs 动态规划"比喻人生哲学,反思硅谷的生产力崇拜,展现了一位在科学与人文之间寻找平衡的研究者的独特视角。
Momenta 上市后,曹旭东再次接受《晚点聊》采访(六年里的第四次),复盘十年创业的判断与取舍:城区 NOA 市场上 Momenta 与华为合计市占率达 90%,智驾摩尔定律从两年十倍加速到每年十倍,2028 年城区 NOA 将达到 人类水平。他讲透了自己 2016 年靠量纲分析推出 1000 亿公里数据需求、从而选定飞轮战略的完整推演, 也首次详细解释 2027 年进入具身智能、2030 年家庭机器人拐点的判断依据,以及一个 World Model 支撑所有自动驾驶应用的底座逻辑。
TBPN 本期深度覆盖了 IBM 创 115 年最大单日跌幅的背后逻辑——AI 资本支出正从传统 IT 基础设施向外迁移;DeepMind CEO Demis Hassabis 提出了迄今为止最详细的美国 AI 监管框架,包含 30 天发布前测试和覆盖开源模型的要求;Dylan Byers 从 Puck 带来 Paramount-WBD 合并案的深度分析,指出在 Netflix、YouTube 和 TikTok 面前,加州 AG 的反垄断诉讼用"影院发行市场份额"来定义垄断已经过时。此外还包括六家 AI 创业公司的融资动态:TerraFirma(建筑机器人)、Greylock 18 亿美元新基金、Reflection AI(10 亿美元算力合同)、Chai Discovery(AI 药物发现)、State Affairs(政策情报)、Cipher Digital(AI 数据中心)。
TBPN 2026 年 7 月特别节目,汇聚六位嘉宾深度讨论 AI 产业的多条战线:GPT-5.6 Soul 的全面升级与 Arc AGI v3 突破;Meta Muse Spark 1.1 首次 API 收费及其广告 AI 飞轮的战略意义;1X 发布 Neo 仿生机器手,力量三倍于竞品;Ollama 完成 6500 万美元 B 轮融资,900 万开发者验证开源模型的企业渗透;播客产业从 4500 万增长至 92 亿美元的 12 年历程;以及 D2C 品牌如何用 AI 彻底改造库存预测和广告生产。
本期 TVPN 汇集七位重磅嘉宾,覆盖从 Blue Origin 首次对外融资(估值 $1300 亿)、GPT-5.6 Soul 全双工语音发布,到 Prime Intellect 与 SambaNova 的 AI 基础设施竞赛、Ben Thompson 对 Xbox 二十年战略失误的深度复盘、Paradigm $12 亿前沿科技基金、Overland AI 获美军首个自主地面车辆量产合同,以及 Cult Holdings 打造品牌宗教的五条法则与 Compound Creative 对创作者经济资本化的布局。内容密度空前,是理解 2026 年中期科技投资格局的绝佳横截面。
硅谷101泓君访谈ApoDex首席科学家Simon Du(杜少雷)与李贝宾,深入探讨2026年硅谷最热的模型方向——递归自我提升(RSI)。 从Anthropic承认80%代码由AI自写说起,两位研究员详解了编码能力如何成为自进化的底座、验证(Verification)为何是Apodex的核心竞争力、 Discovery Model与Generative Model的本质区别,以及"品味"为何是顶级科学家与AI之间最关键的分水岭。贝宾更给出了惊人判断:最快半年内RSI闭环就能跑通第一环。
本期「晚点聊」AI 季报迎来 26 年第二季度。Anthropic 的 Fable 5 被 Henry 评价为"史诗级能力、灾难级发布",OpenAI 的 GPT-5.6 用 TerminalBench 首次破 90 反攻;coding 市场经历从 Claude Code 到 Codex 的迁移潮与价格战,Anthropic 却在 Q2 实现首次盈利。本季最重要的叙事是 RSI(递归自进化)——Anthropic 发文《One AI Builds Itself》,Recursive、Merindale、Core Automation 等新公司批量涌现;中国开源模型八周内四次易主,Harvey 用 GLM 5.1 后训练出自己的模型;机器人与世界模型赛道 18 个月吸金超百亿美元,OpenAI 与 Anthropic 同步官宣机器人团队。Henry 从"推进前沿智能"与"加速智能扩散"两条线梳理全局,并讨论了预训练窗口、企业自有模型与 AI 研究的科学化。
明浩从世界模型的融资热度、视频生成的局限和自动驾驶公司的数据闭环切入,讨论物理世界是否也存在类似大语言模型的 Scaling Law。节目认为,真实数据、仿真、安全与工程部署带来的摩擦,使这条路径不会简单复刻语言模型的发展。
TBPN 多嘉宾期,涵盖三条主线:GLM 5.2 开源模型打破闭源领先叙事并登上《华尔街日报》头版;Google 因产能不足限制 Meta 的 Gemini 用量,揭示 AI 算力瓶颈;Micron 记忆芯片价格飙升(DRAM +60%,NAND +80%),AI 产业链利润向芯片制造商大规模转移。同时八位嘉宾深度访谈:National Design Studio 的 15MB 浏览器 PII 模型、Sigletree 的量子加速 AI 服务器、General Intuition 的万亿动作 token AGI、Tracer 的地下防御无人机、Engram 的持续学习 AI、Sail Research 的极致推理效率、Cadence 的临床 AI 慢性病治疗、Despicuous Ventures 的 El Segundo 硬科技生态。
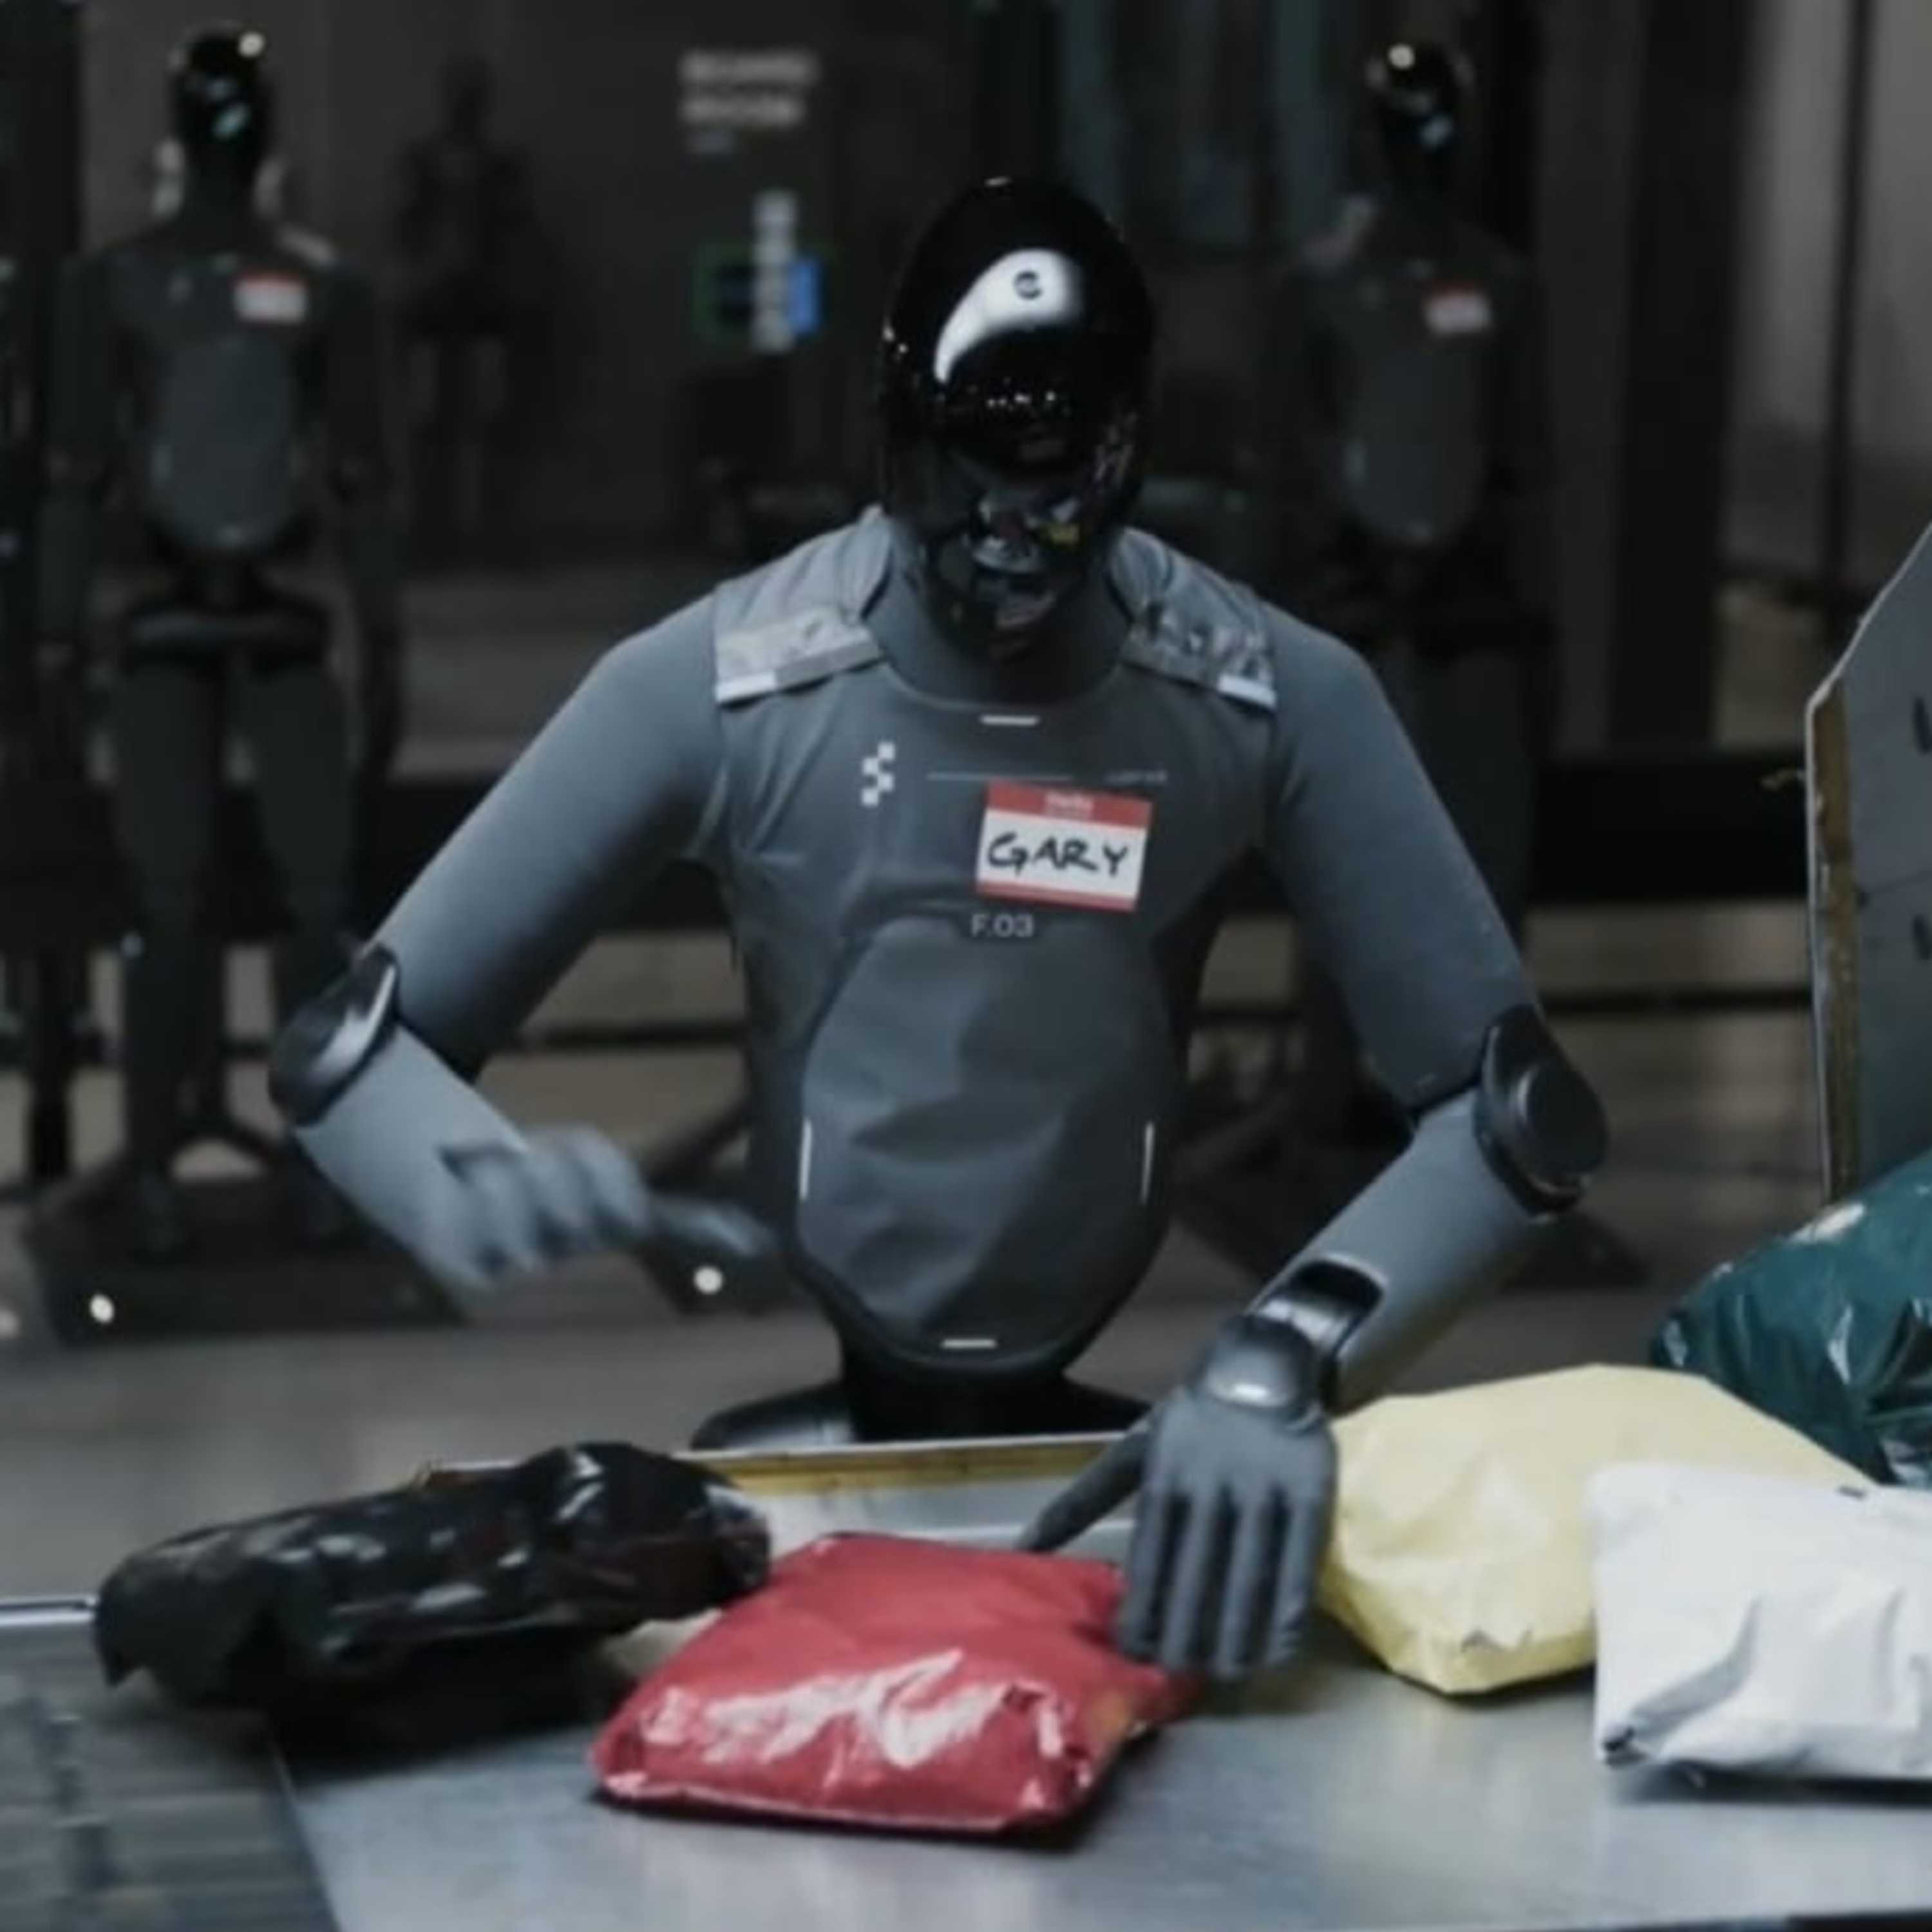
晚点聊「具身季报」系列第二期,AlphEast 创始合伙人陈哲(Peter)与主持人程曼祺复盘 26 年 Q2 具身智能 Top 5 进展:荣耀在亦庄人形马拉松包揽前三、Figure 直播分拣 13 万个包裹、五脊二代手领跑 ICRA 灵巧手竞争、英伟达发布全开源 Omni model Cosmos 3 掀起世界模型创投热、Pi 0.7 与 Gen-1 让 VLA 叙事继续延伸。节目还讨论了数据采集范式的演进、绳驱与直驱的技术路线之争、OpenAI 与 Google 的入局、具身模型的两极终局,以及大厂入场的"最后窗口"。
明浩以“素材之死、流程之死、版权之死”为框架,讨论生成式 AI 如何改变内容生产的对象、短剧的制作与分发方式,以及内容权利的资本含义。演讲从世界模型与短剧讲到 AlphaGo、现代艺术和文艺复兴,最后把问题留给创作者:工具与资本已经在场,人类愿景仍要由人提出。
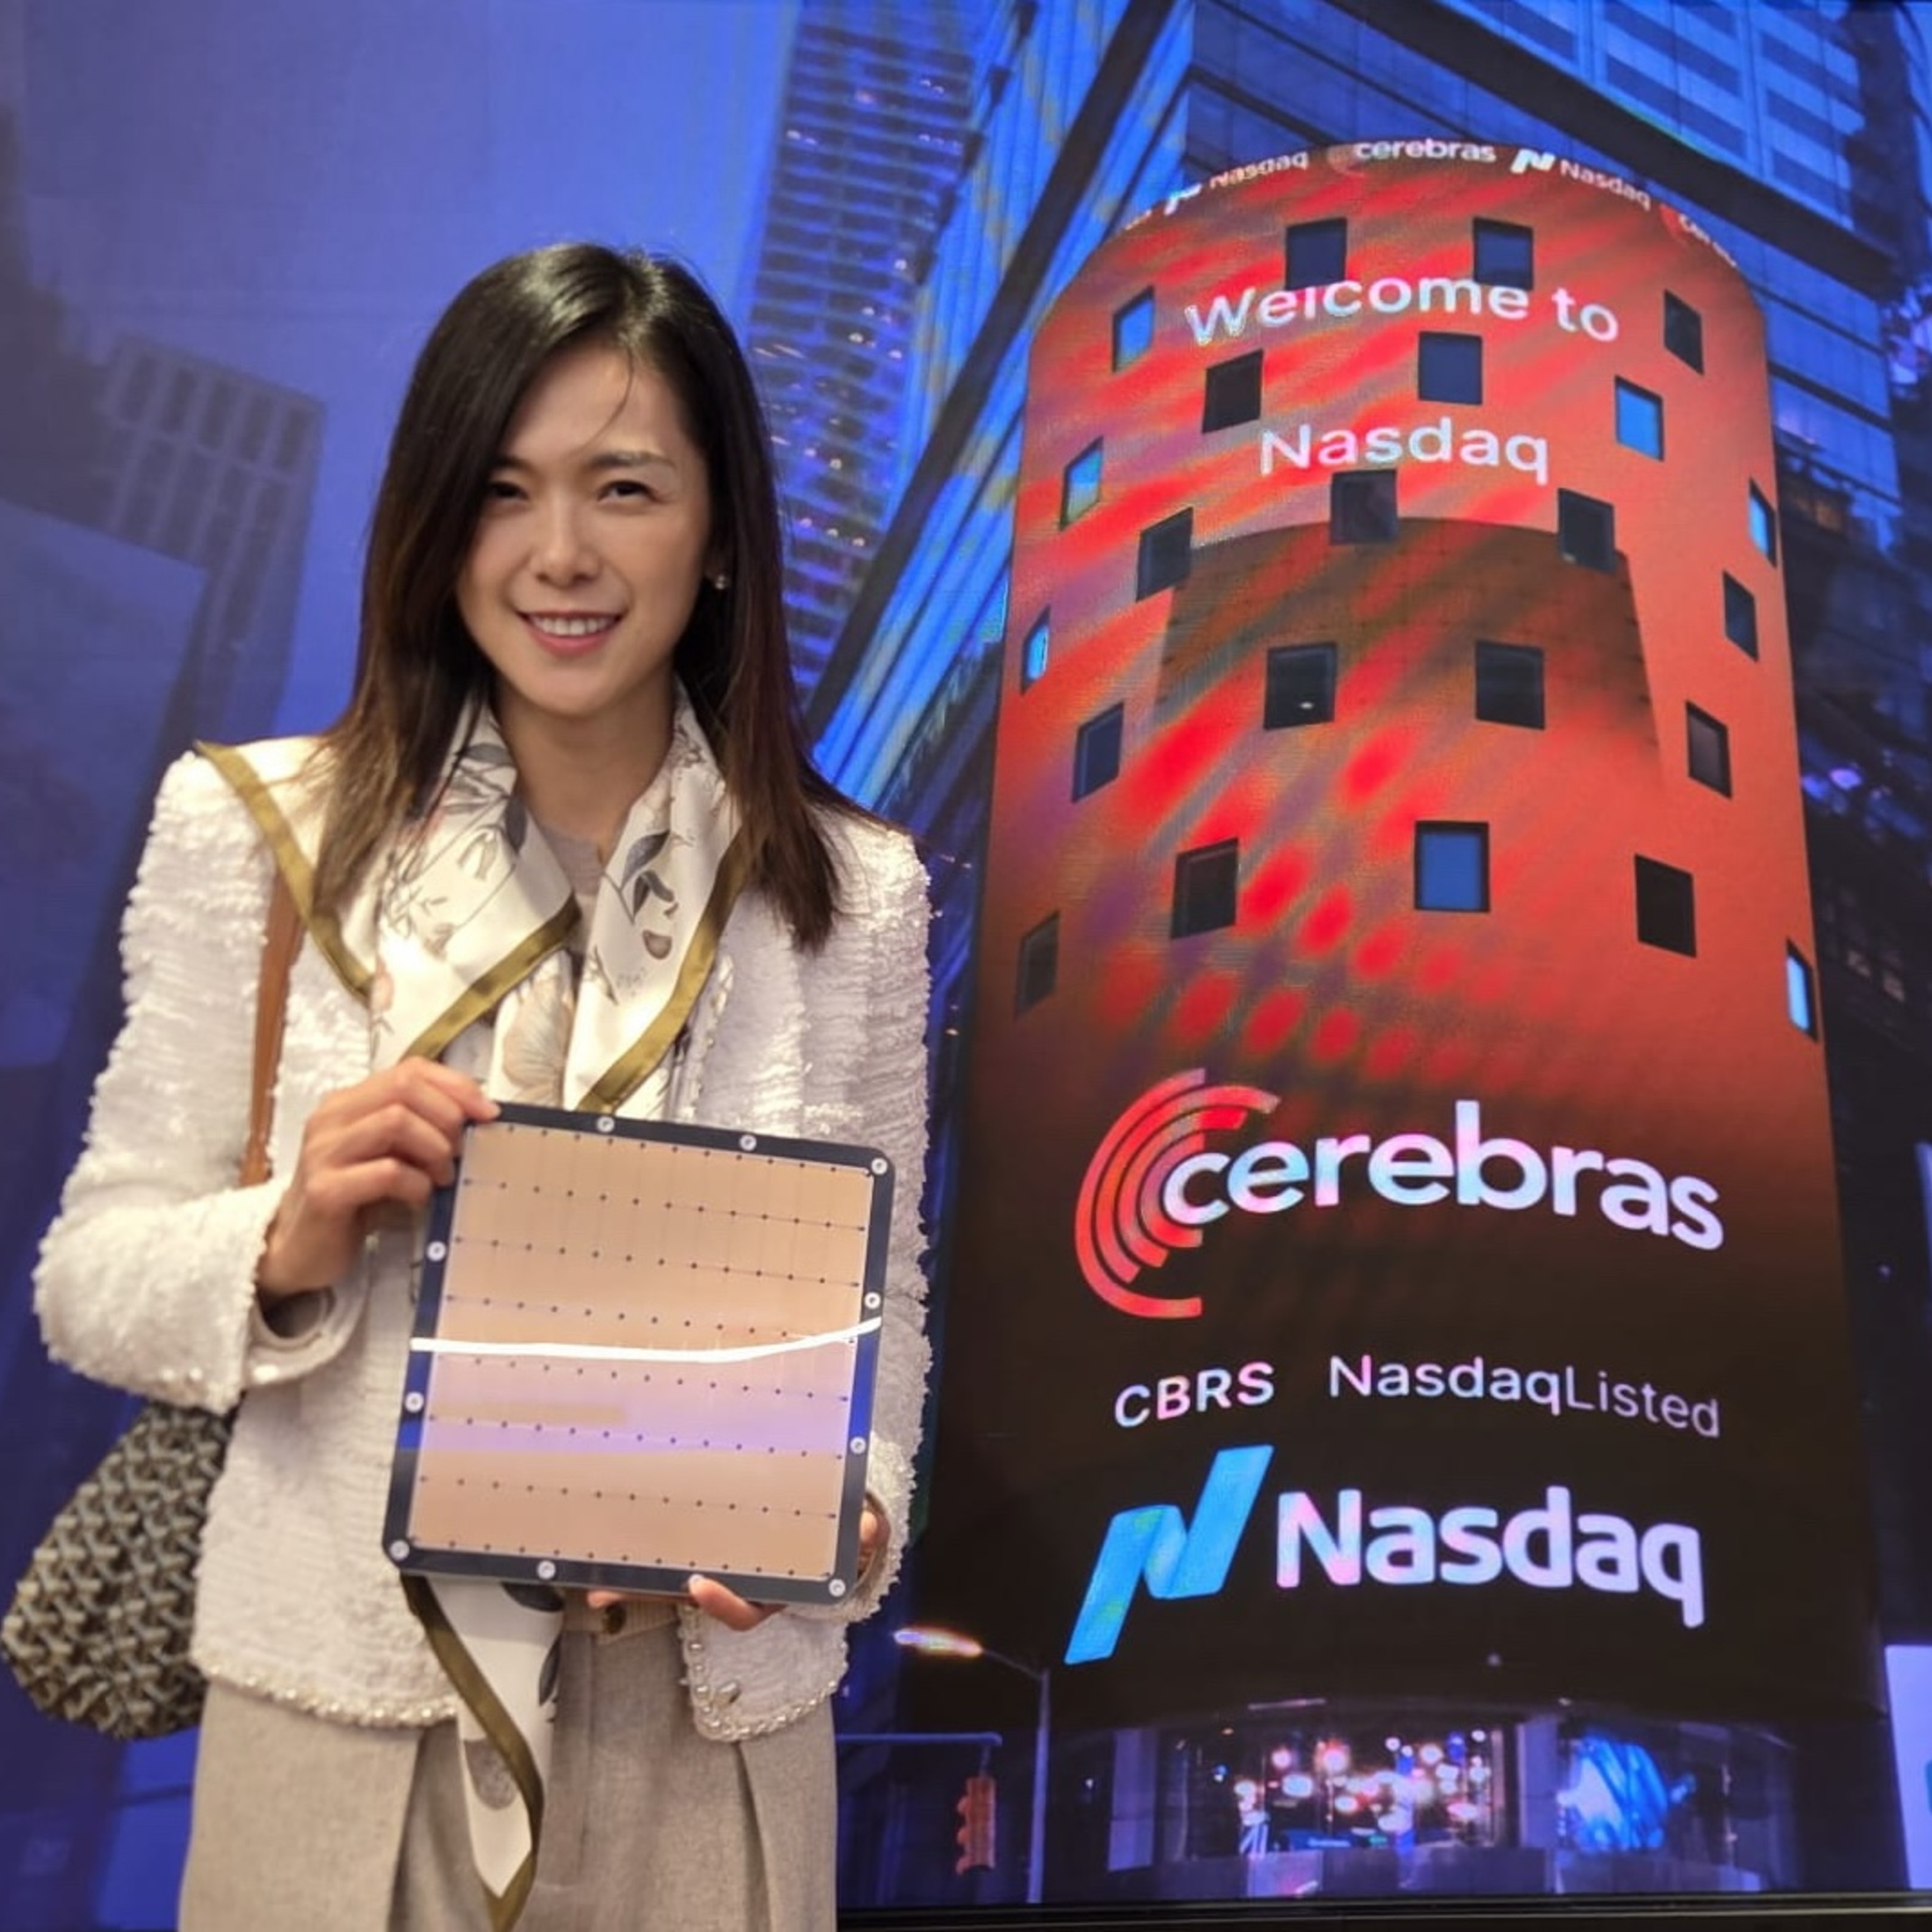
高通创投投资人周南回顾他十年前在百度美研完成的第一笔投资——Cerebras:从研究员的第一课 「不能只依赖英伟达这一个芯片」,到 2017 年以约 7 亿美元估值、两天通过投决的尽调全程。 节目也借 Cerebras 上市与 OpenAI 200 亿美元订单,讨论了算力从训练转向推理的大背景, 以及 Deep Speech 2 论文里 Scaling Law 的萌芽、百度美研这所硅谷黄埔军校的兴衰, 还有一只因中美地缘政治没能做起来的基金——OpenAI、Databricks 都曾躺在它的 deal list 上。
Delphi Ventures 创始合伙人 Tommy Shaughnessy 揭示前沿 AI 实验室的订阅定价被补贴约 40 倍,企业从订阅迁移到 API 时撞上"费用墙",Uber 和 Microsoft 已开始削减支出。开源推理提供商以 1% 的成本提供 80-90% 的质量,正在分流企业客户。OpenAI 降价背后既有客户流失的压力,也有打击 Anthropic IPO 的战略考量。中国开源模型可能转向闭源——如果质量未超越美国,反而帮到 OpenAI 和 Anthropic。Crypto 在资本形成、抗审查访问、去中心化数据和开源社区治理四个方向上,提供了修补 AI 商业模式的潜在方案。
前SpaceX火箭首席制造工程师洪力德(Louis Hong)口述SpaceX开发史与马斯克管理内幕。 七年内部视角讲述猎鹰9号从一年发射一次到年产百次的量产扩张、马斯克"可乐罐"式第一原理推问、"接受你辞呈"的冷酷管理、十倍级思维。 深入星链的物理逻辑、SpaceX收购xAI与太空数据中心的底层原因、太空产业链Apple/Android双生态投资框架,以及为什么2026年是太空赛道的转折点。
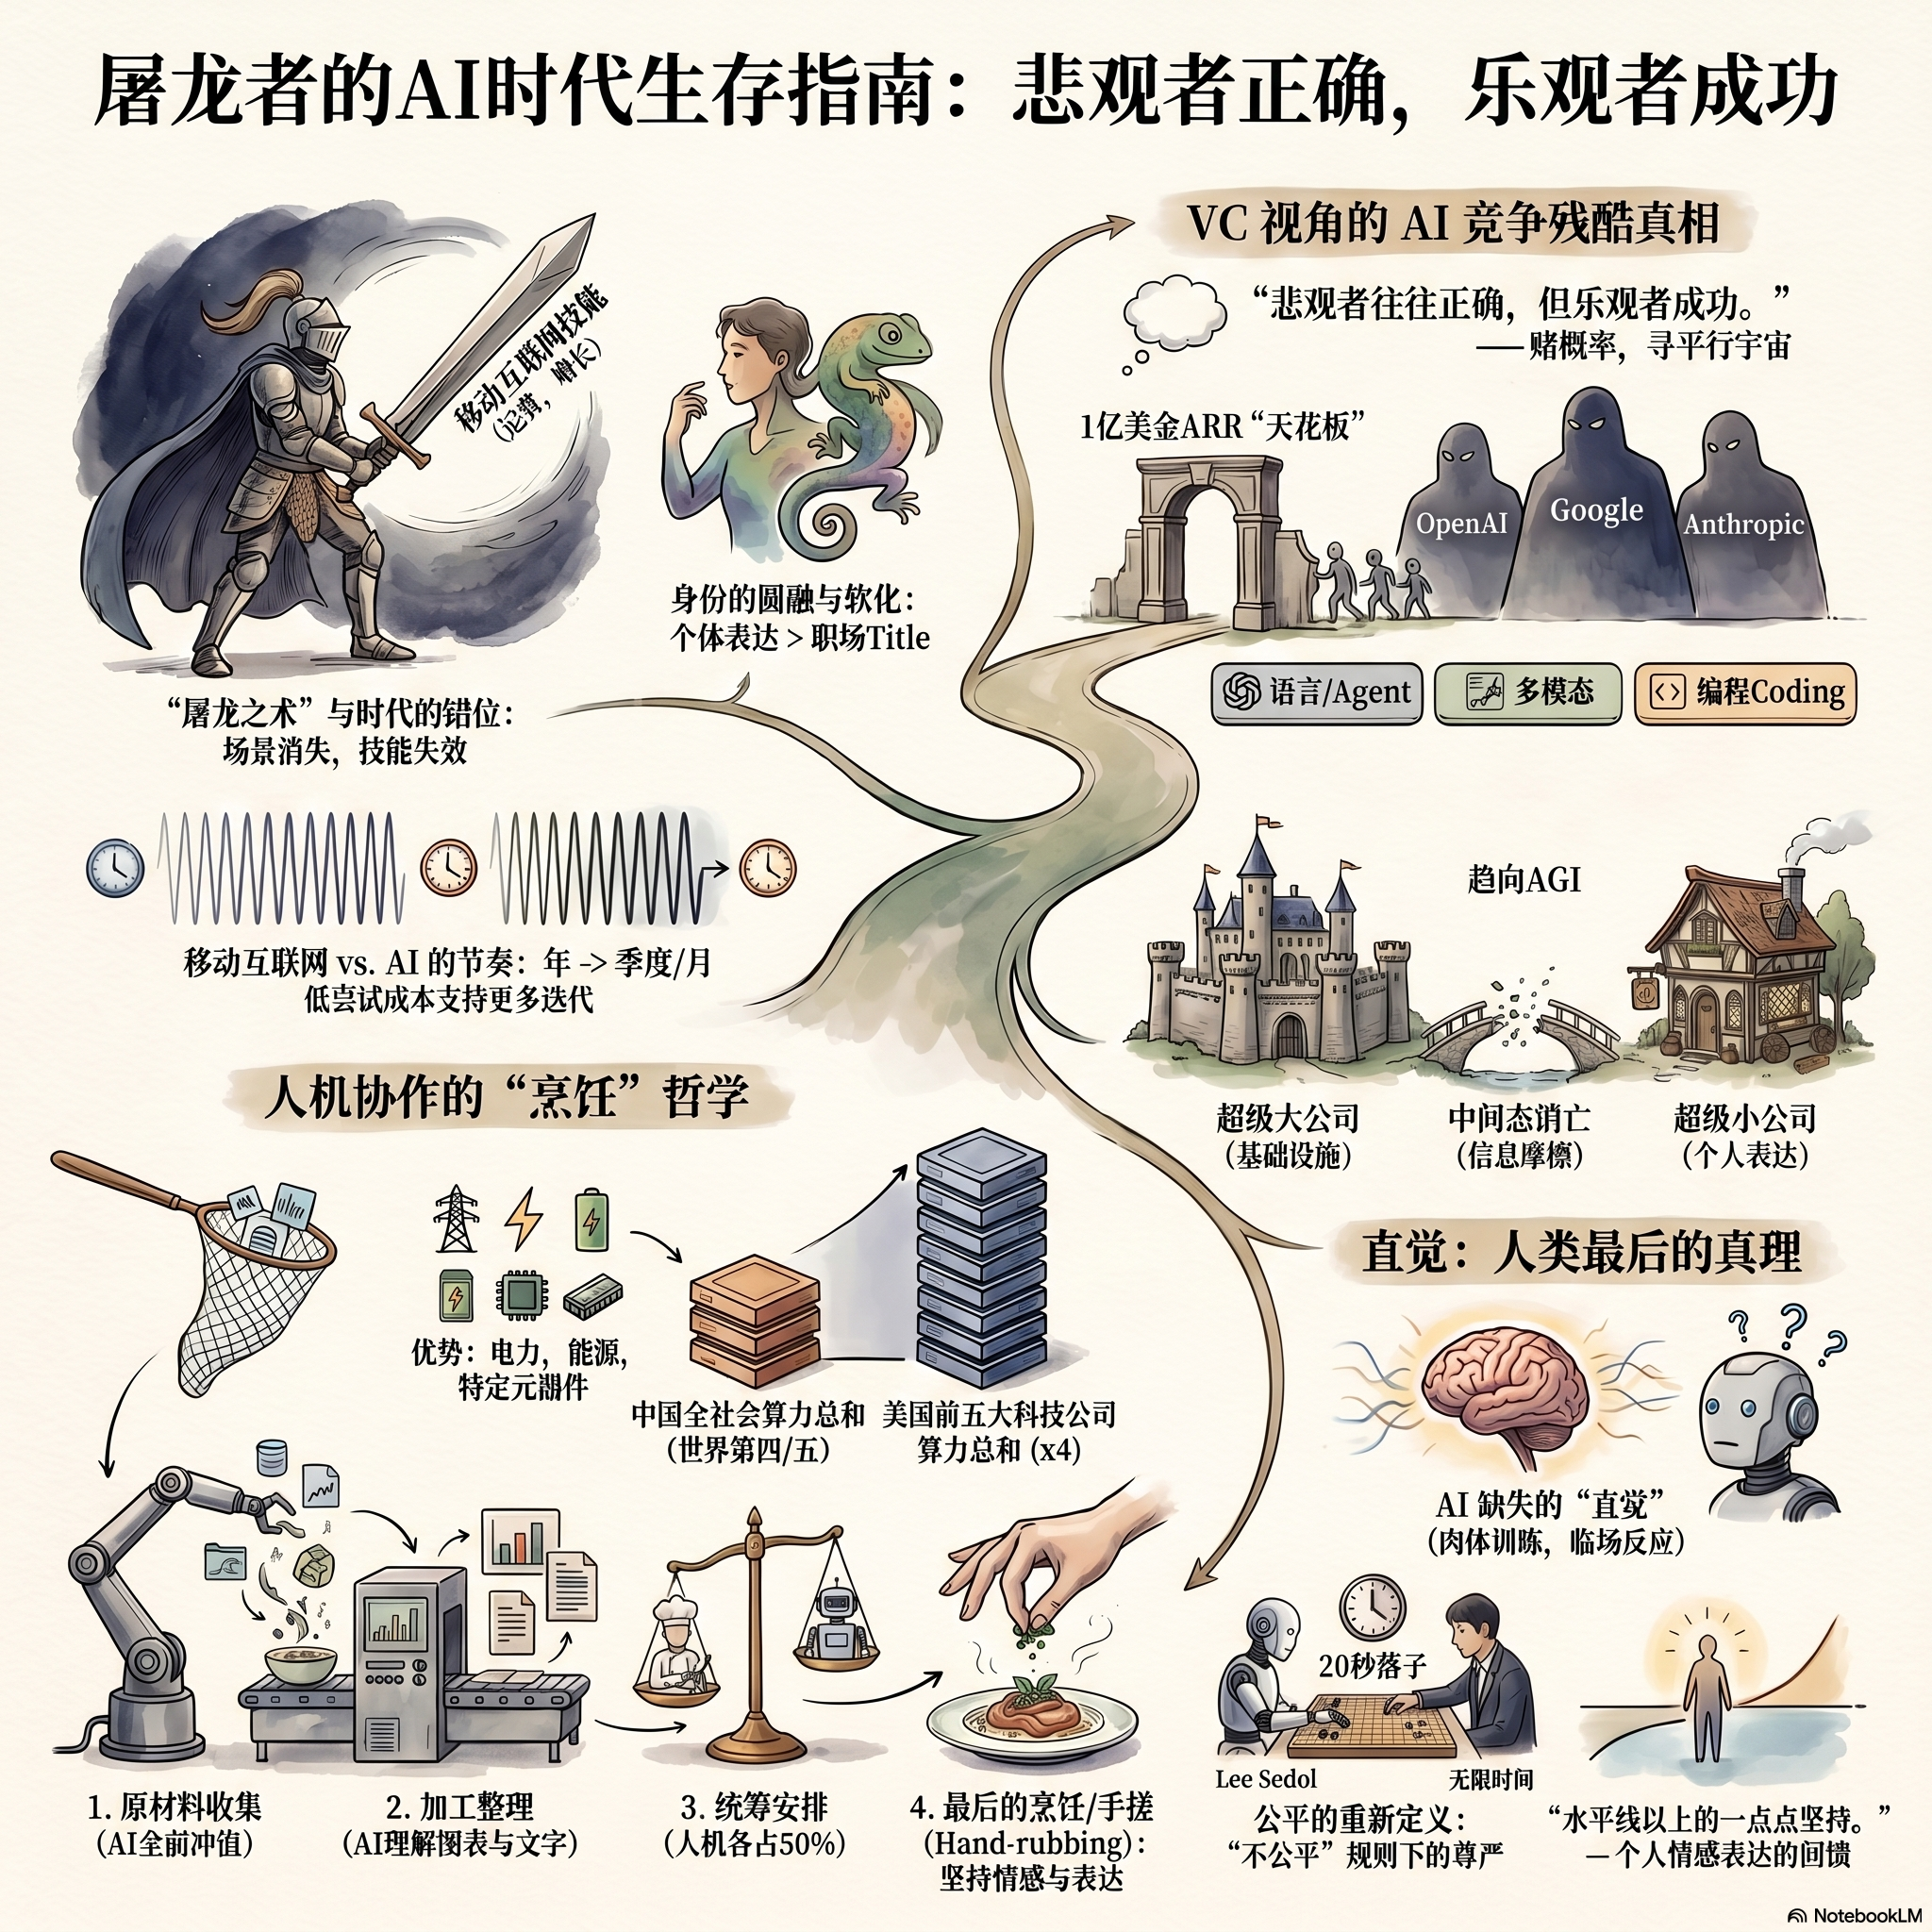
庄明浩从移动互联网与一级市场的经历出发,解释为什么 AI 时代的投资试错更快,也为何应用公司的护城河需要不断重估。对谈进一步讨论生成式内容的版权与审核、模型竞争、企业采用,以及人在就业、创作和人机竞赛中如何重新理解公平。
TBPN 2026 年 5 月 29 日节目,涵盖 Blue Origin New Glenn 火箭爆炸、企业 AI token 预算失控(Anthropic $470 亿 ARR 冲击)、恐龙化石市场暴涨、SpaceX $2 万亿 IPO 分析、John Gruber 对 Apple WWDC 2026 AI 策略与软件质量的深度解读、三场融资闪电战(Trajectory $1500 万、PicoGrid $4500 万、Pace $4600 万)、Kyle Kuzma 的运动员投资哲学,以及 Brad Gerstner 的 Token Flow 理论、NVIDIA 估值悖论和 Trump 账户启动。
许华哲在离开星海图后再次创业,成立破壳机器人,目标是把通用智能(physical AGI)送进家庭。 他判断未来 18-24 个月会有一台机器人真正走进家里做事,并主张具身智能应该走 AI native 路线: 不是传统机器人学、不是自动驾驶、不是史前深度学习,而是统一大模型加全部数据加规模化后训练。 节目还聊了他对行业"卖数据、无脑量产、跳舞"三大现象的批评,以及从科学家到创业者的人生转变。
TBPN 六嘉宾重磅节目:SpaceX 提交 S-1 申请史上最大 IPO($28.5T TAM),Anthropic Q2 收入 $109 亿即将盈利,OpenAI 通用模型破解 90 号 Erdős 猜想。经济学家 Alex Tabarrok 解析 Baumol 效应与 AI 对服务业的影响,Spotify 联合 CEO Alex Norström 揭示粉丝经济四大赌注,Jordan Schneider 解读中美科技僵局,Bill Clerico 发布 $85M 灾害韧性基金,Erik Bernhardsson 介绍 Modal $3.55 亿 C 轮与 GPU 市场现状。
高深远(港科大博士、NVIDIA GEAR Lab 成员)从自己研究世界模型三年的视角,先把"世界模型"拆成决策派与知识派、再按表示方式分成粒子、显式 3D、隐空间与视频四个流派,论证视频空间是当前最 promising 的路线。随后他展开 GEAR Lab 的 DreamDojo 与 DreamZero 两项工作:前者用约 4.4 万小时人类第一视角视频给 action-conditioned 世界模型迁移泛化能力并做到实时,后者以视频为 backbone 把 VLA 策略与未来状态预测合二为一。最后他解释了由 agent、policy 与世界模型构成的自进化循环,为什么他认为这个循环今年可能出现临界点、但真正爆发需要五年,以及评测没有 zero-shot benchmark、长程记忆缺失等现实瓶颈。
明略科技创始人吴明辉在 OpenClaw 掀起个人 Agent 热潮后,宣布 SaaS 行业已死:闭源软件分分钟被 AI 复刻,明略转向开源 + Agentic Service(结果即服务)模式。节目中他详细拆解了把 OpenClaw 从个人助理改造成团队协作者的实践、多只专长龙虾在群聊里产生集体智慧的章鱼 Octo、品鉴者体系与龙虾商业伦理学,并复盘了 2020-2022 年千人大团队做组织智能(EIP)最终裁员一半的教训。他给出的终局判断是:基模 Scaling up 到今天已经足够,下一步是靠 Scaling out(集体学习与组织智慧)和人的 Taste 取胜。
TBPN 全程深度覆盖 Trump-Xi 北京峰会、AI 地缘政治与芯片出口博弈、SpaceX-Google 轨道数据中心竞争,以及七位创业者的一线洞察:Max Levchin 谈 AI 编码 75% 占比与深度专业化、Delian Asparouhov 宣布人类首次太空商业制药、Richard Socher 携 $6.5 亿出关打造递归自我改进超智能、Nebius AI Cloud 841% 增长的幕后故事。
王铁震认为,美国前沿模型在复杂任务的使用体验上仍明显领先;但若以国产模型是否跨过实际可用和付费门槛衡量,中国模型正在进步。讨论从 KV cache、国产卡适配和训练资源,延伸到开源生态、真实任务的数据循环,以及能力扩散后的社会影响。
俄亥俄州立大学教授、斯隆研究奖得主苏煜从技术史纵深复盘了 AI Agent 的演化——从 1950 年代的逻辑智能体到今天的 Language Agent。 他深入剖析了 OpenClaw Moment 与 ChatGPT Moment 的类比、Coding 作为数字世界根基的洞见、以及 Agent 从通用到专精的关键瓶颈。 苏煜还分享了他的创业公司 New Cognition 的愿景:让 Agent 通过持续学习构建"工作世界模型",成为各个领域的专家。
一场单人演讲以 2026 年 4 月的图表和案例为线索,讨论 Agent 与 Harness 如何改变模型产品,coding 为何在当前竞争中居于中心位置。演讲随后转向模型公司的用户与收入指标、SaaS 和科技股的重估、数据中心投资及其地方成本,最后落到 AI 加速带来的焦虑和个人选择。
DeepSeek V4 发布后,晚点聊邀请两位一线 AI 从业者——UCLA 博士生刘一峰与 sglang 核心团队 RadixArc 的赵晨阳——逐层拆解技术报告。V4 并非新范式,而是在 R1 的测试时扩展范式下,通过混合稀疏注意力、Muon 优化器、MHC 结构、Triton 与 FP4 四组互相耦合的组合创新,把百万上下文从"理论可行"推进到"成本可接受"。节目同时讨论了 3% 的极致激活比例、FLOPs 降到 27% 的效率革命、训练成本数字的消失、token 浪费的行业隐忧,以及中美两种模型路线的差异。
小米大模型负责人罗福莉的 3.5 小时深度对谈:从春节凌晨 2 点 OpenClaw 觉醒,到 MiMo V2 系列 (Pro / Omni / TTS) 的"悄无声息伏击",再到 Agent 时代后训练算力 1:1、组织扁平化、AGI 两年内可期。 当下范式已从 Chat 切到 Agent —— 1T 基座 + 后训练敏捷性是新的入场券。
小米大模型团队负责人罗福莉的第一次长时间技术访谈。她系统阐述了 OpenClaw 如何成为一个划时代的 Agent 框架,以及 Agent 范式如何从根本上改变了模型训练的经济学——从预训练主导向后训练与预训练并重转变。访谈涵盖 MIMO V2 家族(Pro/Omni/TTS)的架构哲学、Hybrid Attention + MTP 的技术选择、1T 参数模型的训练挑战、组织平权实验,以及对 AGI 时间线和中美代差的判断。
唐文斌回顾了从信息学竞赛、旷视创立到物流机器人业务的十五年经历,解释技术团队如何从体感游戏转向 Face++、身份认证和仓库机器人。他也分享了原力灵机对具身原生模型、真实使用数据、场景闭环和模块化硬件的判断,并把新公司的阶段目标落在一个可持续运行的真实场景上。
张小珺对 24 岁 Axiom 创始人洪乐潼的 4 小时长访谈。00 后华人女孩、MIT 摩根奖得主、 斯坦福数学博士辍学、A 轮 16 亿美元。访谈把 AI for Math 的来龙去脉讲透——从 1960s ATP 到 2024 年 DeepMind AlphaProof,再到 2025/12 Axiom 拿下 Putnam 满分 98.93%; 也讲透了洪乐潼的创业心智:蛮力型选手、对苦难上瘾、bet system not model、 把自己定义成 "research scientist intern" 而非 CEO。
24岁的00后华人女孩洪乐潼创办了AI for Math公司Axiom,7个月内从0到16亿美元估值。在这期4小时的深度访谈中,她讲述了从广州奥数少年到MIT蛮力型选手,从斯坦佛法学院到硅谷创业者的独特轨迹。她分享了形式化证明(Lean)如何将数学变成可验证的代码,Axiom如何在普特南数学竞赛拿到满分,以及她为何认为超级智能应该是专用的(ASI)而非通用的(AGI)。
黄晓煌回顾群核从 2011 年把 GPU 做到云上,到用酷家乐找到设计师和装修公司的付费场景,再到大厂竞争、行业周期与多次业务转向。访谈的后半段聚焦空间智能,解释 SpatialLM、SpatialGen、真实与合成数据,以及群核为何选择三维模型作为连接大语言模型和物理世界的路线。
广密与主持人小俊回顾 2026 Q1 全球大模型进展。核心判断:Coding 已从 chatbot 第一幕跨入 agent 第二幕,Opus 4.5→4.6 带来 GPT-3→GPT-4 级别的代际提升。深度分析硅谷御三家 Anthropic/OpenAI/Google 的战略分化、组织文化差异与关键误判,探讨模型成为新一代操作系统的终局路径,以及白领通缩与失业的社会影响。
这期 Solo 讨论 V4 发布前的 DeepSeek:近期少量研发人员流动,如何与 AI 人才竞争、期权定价和 V4 的等待交织在一起。节目也拆解梁文锋对 AGI 的理解——除了提高模型智能上限,还要建设国产生态、投入回报不确定的原创方向;与此同时,产品触点、Agent 竞争和算力约束正在重新定义这家公司的压力。
陈哲从宇树春晚表演和招股书出发,解释人形机器人的进展为什么首先体现为本体、运控和量产一致性,而不是一段好看的视频。对谈继续讨论高自由度灵巧手、触觉、世界模型、数据金字塔与端侧算力,比较中美公司在硬件供应链和模型资源上的不同位置。 这期季报没有给人形机器人下定论,而是把几个仍在变化的变量摆在一起:形态是否必要,世界模型能否超过 VLA,触觉数据如何积累,以及上市潮会如何筛选真正能交付的公司。
Henry Yin 从 OpenClaw 的个人助理形态出发,分析 Claude Code、Codex 与模型厂商如何把竞争推进到产品、生态和企业部署层面。节目也讨论了 Auto Research 所代表的自进化实验、持续学习的技术边界,以及 Agent 对推理基础设施、组织配置和劳动市场的影响。
张小珺《商业访谈录》第 134 期:和光轮智能 CEO 谢晨把 AI 的"数据"这架马车 做成一次产业综述。从数据 = 教育的第一性类比,到朱玉可提出的数据金字塔 (真机 / 仿真 / 人类第一人称视频),再到为什么特斯拉模式在具身不成立、 BEHAVIOR Challenge 的 26%、为什么"先失败再成功的数据最贵",一直到终局: 一家 AI 教育公司,提供环境让模型自己修炼内功。
光轮智能创始人兼CEO谢晨(Steve)以跨越物理、量化金融、自动驾驶、具身智能的独特视角,完成了一期关于AI数据产业的深度综述。从数据≈教育的第一性框架,到数据金字塔的构成与定价,到"先失败再成功"的数据质量新标准,再到五家大模型团队角逐机器人大脑的版图——这期节目试图用一集讲清楚驱动AI的三驾马车之一:数据。
谢赛宁的第一次播客访谈,7 小时马拉松对谈, 覆盖 SJTU ACM Class、UCSD 屠卓文、FAIR 何恺明、NYU 李飞飞, 到 2024 年和 Yann LeCun 共同创立 AMI Labs 的全过程。 贯穿主线:representation learning 是 12 年都没解决的核心问题, LLM 是 virtual intelligence,world model 才是真问题。
NYU 助理教授谢赛宁(Saining Xie)在 7 小时的深度对谈中,完整回顾了从交大 ACM 班到 NYU、从表征学习研究到与杨立昆联合创立 Emi Labs 的历程。他系统阐述了何为世界模型、为什么 LLM 不是通往通用智能的地基,分享了两次拒绝 Ilya Sutskever 的底层逻辑,以及 DiT 如何从一篇被拒稿的论文变成 Sora 的骨架。
谷歌前TPU工程师Henry首次公开揭秘,从硬件架构、XLA编译器生态、供应链瓶颈到Anthropic百万订单背后的故事,深度解析谷歌TPU能否撼动英伟达GPU垄断地位。核心结论:GPU与TPU必然共存,未来芯片市场将百花齐放。
高岱恒从千问团队变动后的人才搜索变化讲起,解释开放模型如何借由模型社区、论文与开发者反馈形成影响力。他也回顾自己的开源经历和 AI 研究者故事,并讨论了以公开作品发现人才、以 Agent 改变招聘与任务协作的可能性。
明浩以 2026 年 2 月的行业事件为窗口,分别梳理美国的算力投入、英伟达、Agent、软件股和 OpenAI 融资,以及中国的模型发布、视频生成、春节获客和模型公司估值。节目把市场情绪、公司披露和条件性推演放在一起讨论,也保留了算力供需、留存、监管与就业影响等尚无定论的问题。
硅谷101邀请《哈萨比斯:谷歌AI之脑》中文译者周健工,深度解读DeepMind创始人德米斯·哈萨比斯的传奇人生。从四岁下棋的神童到AGI运动的发起者,从谷歌6.5亿美元的惊天收购到AlphaGo击败李世石、AlphaFold破解蛋白质折叠难题并斩获诺贝尔化学奖。节目沿着两条AI路线的学派之争(强化学习vs深度学习),梳理了DeepMind的崛起、与谷歌的博弈、苏莱曼的恩怨纠葛,以及ChatGPT冲击下DeepMind如何从落后到追赶。最终回到那个悬而未决的问题:一个想用AI理解宇宙的科学家,能否控制自己亲手创造的力量?
曼琪以 2025 年的模型进展、Agent 应用、巨头竞争、创业融资、具身智能与 AI 硬件为线索,回顾技术如何进入产品和组织。 节目也把视角放回使用者:当工作内容与人才市场被重写,人如何在效率变化中保留经验、关系和意义感。
庄明浩以 2026 年 1 月的视角,回看 2025 年美国和中国 AI 行业的模型、产品、基础设施与资本变化。他把美国的高强度数据中心投入、应用与模型的收入压力,同中国的开源模型、超级应用和硬科技融资放在一起,也保留了商业回报与两国长期格局尚无定论的部分。
硅谷101主持人洪君对话阿里云千问大模型业务总经理徐栋、影石科技CEO刘靖康与360研究院总监齐露、语义科技CEO吕总,从模型技术进化与商业化的两条线索出发,探讨了视频生成模型从娱乐走向生产化管线的突破、语言模型在数据精耕与稀疏化上的持续进化、Agent从Chatbot向自主运行的跨越、端云结合的新范式、开源生态的飞轮效应,以及中国企业在AI商业化中的真实实践与思考。
庄明浩回顾 DeepSeek-R1 发布后的一年:开源推理模型改变了竞争叙事,Agent 与多模态把能力从聊天带向执行和内容生成。对谈也把持续学习、世界模型、平台化和巨额资本开支放在一起,讨论技术进展为何尚未消除商业化与估值的分歧。
印奇在AI行业深耕15年后,从旷视科技联合创始人到同时出任千里科技与阶跃星辰董事长。这场深度对谈中,他复盘了AI 1.0时代的战略失误——"把把都上"的安防之战、上市作为目标的迷失,并提出做基模的商业模式排除法(to B和纯C端软件都不成立),明确"软硬结合+终端"的路线。他坦诚讨论了聪明人的ego陷阱、AI时代组织形态的挑战,以及用"想做×能做×可做"三要素交集做战略取舍的方法论。
范浩强与高阳从 RoboChallenge 的 Table30 出发,讨论具身模型为何难以在真实世界中公平测评,以及少样本微调与零样本评测分别回答什么问题。对谈还梳理了数据规模化、单帧模型的记忆缺口、演示可信度和机器人商业化所需的能力门槛。
陈亦伦从 2021 年自动驾驶端到端实验讲起,解释为何他把运动控制、大模型任务规划和端到端学习视为具身智能的三道曙光。访谈的重心落在数据:它石智航希望用可穿戴手套和第一视角相机,在真实工作场景中记录人类操作,再让模型学习空间、接触与力的变化。团队计划先在工业制造等已有大量人工操作的场景检验技术价值。
明昊复盘 AGI Next 现场的三场演讲与一场论坛:模型公司正把注意力放在 Token 效率、长上下文、多模态、持续学习和 Agent 上。围绕 To B 与 To C 的分化、下一代学习范式、Agent 的企业价值及中美竞争,与会者给出了不同判断,也明确了算力、成本、市场和治理等约束。
张小俊在智谱IPO上市当天与CEO张鹏进行了一场三小时深度长谈。从清华实验室到港交所,从"第一个吃螃蟹"的科技成果转化到全球大模型第一股,张鹏完整回顾了智谱六年半的创业历程:技术路线的选择(GLM架构)、ChatGPT前后的融资冰火两重天、百模大战的焦虑、Scaling Law的不迷信、To B与To C的路径抉择、DeepSeek冲击后的反思,以及始终不变的AGI信仰。
Risky Business #839 深度解析 2026 年 5 月的安全新闻头条。TeamPCP 通过 VS Code 恶意扩展入侵 GitHub,窃取 3,800 个内部仓库。Anthropic Mythos 发现 10,000+ 软件漏洞,但 AI 也在以史无前例的速度制造新 bug。MCP 安全扫描揭示 AI 基础设施正在重蹈早期 Web 的安全覆辙。DigiCert 被恶意屏保入侵,攻击者获得 Tencent EV 代码签名证书——而微软同期意外从 4% 的 Windows 设备中删除了 DigiCert 根证书。